Malý model, pečlivě navržený pipeline
Metoda autoresearch pro zmenšení rozdílu oproti frontier LLM při dlouhém sumarizování více dokumentů. Testováno na přípravních přehledech před sezením sestavených z přepisů dvou syntetických pacientů.
Levný model se může přiblížit, pokud toho dělá méně
Frontier jazykové modely dobře sumarizují dlouhé materiály složené z více dokumentů, ale jejich použití před každým výstupem je nákladné. Malé modely jsou levné, ale při dlouhých vstupech ztrácejí informace. Zkoumali jsme, kam až se může dostat levný model, když je součástí pečlivě navrženého pipeline a vylepšuje ho automatizovaný cyklus, který každou změnu vyhodnocuje pomocí dalších modelů, bez lidských hodnotitelů.
Po více než 30 verzích a 16 kolech zaslepeného hodnocení se skóre malého modelu podle váženého zlatého kontrolního seznamu zvýšilo z 0.647 na 0.846 (0.879, když výběr ze tří běhů provede verifikátor bez přístupu k referenci). Referenční frontier model dosáhl skóre 0.782. Při zaslepeném hodnocení supervizorem LLM nebylo možné při této velikosti vzorku oba modely rozlišit: průměrný párový rozdíl činil +0.05 (SD 0.49). Tentýž, nezměněný referenční přehled dostal od tohoto supervizora v průběhu 13 kol hodnocení od 3.50 do 4.03, takže vlastní šum hodnotitele se ukázal být samostatným zjištěním.
Obsah
Dlouhý vstup, pevná struktura, rutinní použití
Mnoho praktických úloh sumarizace má tři společné vlastnosti: vstup je dlouhý a rozložený do mnoha dokumentů, výstup má pevnou strukturu s počty, daty a doslovnými důkazy a vytváří se rutinně, takže záleží na nákladech.
Jako testovací úlohu jsme použili jeden takový případ: strukturovaný přehled, který může terapeut KBT přečíst přibližně za tři minuty před sezením. Uvádí základní přesvědčení s počty sezení, pravidla, opakující se zkreslení, typické epizody ABC, ověřované předpovědi, poslední sezení a body, které terapeut může chtít otevřít v dnešním sezení. Do 20. sezení má materiál přibližně 130,000 slov.
Tato úloha se hodí pro metodologickou otázku, protože má známou strukturu (kognitivní model Beckové), přirozenou podobu ověřitelného důkazu (doslovná slova pacienta) a několik úskalí: přesvědčení, které nejprve formuloval terapeut, nebo metaforu, která není výrokem o smrti.
Dva syntetičtí pacienti
Oba pacienti byli vytvořeni pomocí naší vrstvené metody syntetických pacientů (nejprve profilový list, terapeutický oblouk, plán sezení a průvodce hlasem, poté jednotlivá sezení generovaná postupně jako přepisy ve stylu ASR). Anita: 20 sezení, 131,498 slov, KBT ve stylu J. Beckové. Markus: 12 sezení, 83,978 slov; jeho terapeut částečně pracuje se schematerapií, takže přehled musí převést materiál zpět do pojmů KBT. U každého pacienta byla zlatá referenční verze vytvořena nezávisle na základě úplného přečtení přepisů. Nebyla použita žádná data skutečných pacientů.
Rozdělení práce
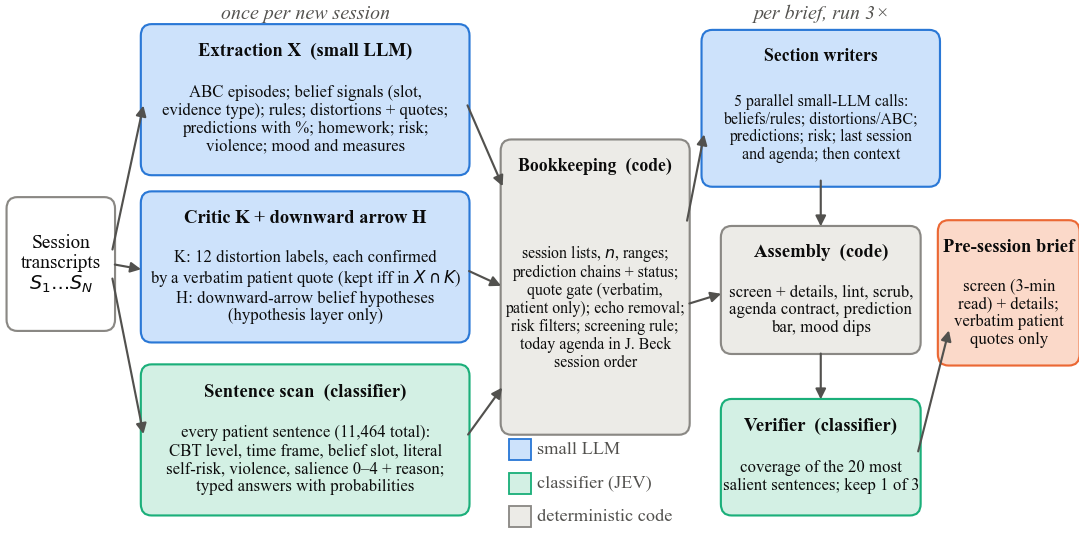
Rozhodující změny nespočívaly ve vylepšení promptů, ale v novém rozdělení odpovědností. Každá komponenta dělá pouze to, v čem je dobrá.
Deterministický kód
Vše, co lze spočítat, seřadit nebo ověřit
Seznamy sezení, počty a rozsahy pro každé přesvědčení; řetězce předpovědí propojené napříč sezeními; filtr doslovných citací, který vyřadí každou citaci, jež se nenachází ve vlastních výrocích pacienta; odstranění opakování terapeutových slov; a od verze 28 také pořadí navrhovaných bodů pro dnešní sezení. Jakmile se v tomto kódu najde chyba, zůstane opravená.
Klasifikátor vět
Posouzení, která nevyžadují generování textu
Každá věta pacienta (celkem 11,464) je jednou označena: úroveň KBT (automatická myšlenka, pravidlo, přesvědčení, emoce, chování…), časový rámec (současnost nebo vzpomínka), doslovné či obrazné vyjádření a pravděpodobná významnost věty pro příští sezení; u každé položky se uvádí pravděpodobnost. Tentýž klasifikátor později slouží jako verifikátor bez přístupu k referenci i jako hodnotitel kontrolního seznamu.
Malý jazykový model
Krátké texty vycházející z připravených podkladů
Pro každé sezení malý model extrahuje strukturu, potvrzuje zkreslení doslovnými citacemi a navrhuje hypotézy (ukládané jako hypotézy, nikdy jako důkazy). Pro každý přehled běží souběžně pět autorů jednotlivých oddílů; každý vidí pouze data očíslovaná podle sezení pro svůj oddíl a má výslovně zakázáno vymýšlet čísla sezení nebo citace.
Výběr nejlepšího ze tří, bez nahlížení do odpovědi
Rozdíly mezi běhy jedné verze byly často větší než rozdíly mezi verzemi. Pipeline proto vytvoří tři přehledy a verifikátor jeden vybere: vezme 20 nejvýznamnějších vět pacienta a požádá klasifikátor, aby posoudil, zda se každá z nich odráží v přehledu. Verifikátor nikdy nevidí zlatou referenci ani kontrolní seznam.
Cyklus autoresearch
Automatizovaný vývojový cyklus inspirovaný nedávnou prací na automatizovaném experimentování: navrhnout jednu změnu, spustit ji a ponechat ji pouze tehdy, pokud se shodnou dvě nezávislé metriky.
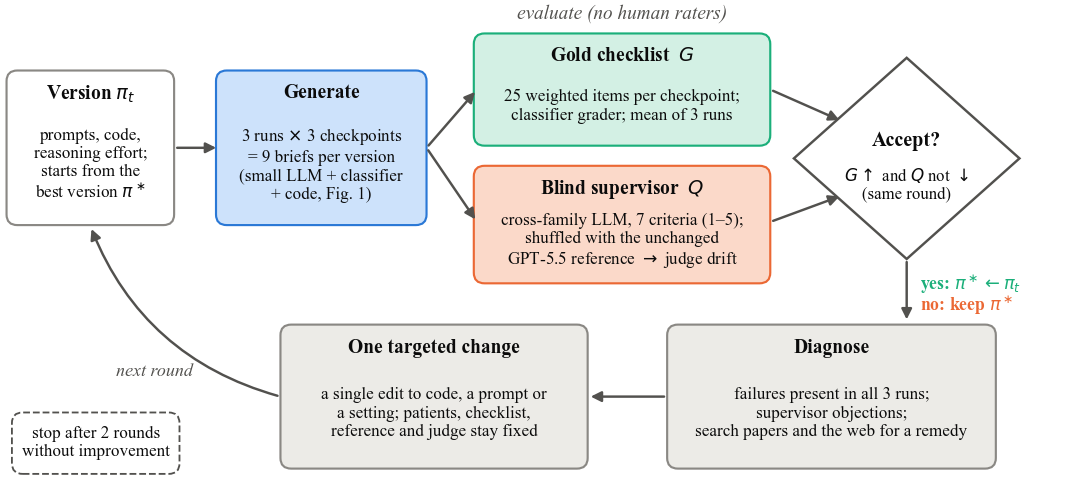
- Dvě metriky. Zlatý kontrolní seznam 25 vážených výroků pro každý kontrolní bod, hodnocený klasifikátorem, a zaslepené hodnocení supervizorem LLM z jiné rodiny modelů, který boduje sedm kritérií na stupnici 1–5.
- Pevná kotva. Supervizor vždy vidí také jeden nezměněný referenční přehled frontier modelu označený náhodným písmenem, takže vlastní drift hodnotitele se měří v každém kole.
- Jedna změna najednou. Selhání přítomná ve všech třech bězích a připomínky supervizora určují jednu cílenou změnu v každém kole; při jejím návrhu se vychází z rešerše literatury.
- Pevné pravidlo zastavení. Cyklus se ukončí po dvou po sobě jdoucích kolech bez zlepšení. Zastavil se na v28.
- Pevný nákladový limit. V pipeline nelze použít žádný model dražší než malý model nebo klasifikátor.
Co jsme pozorovali
Deskriptivní statistiky ze tří kontrolních bodů (Anita před 13. a 20. sezením, Markus před 12. sezením) a tří běhů každé verze.
Pokrytí obsahu: zlatý kontrolní seznam
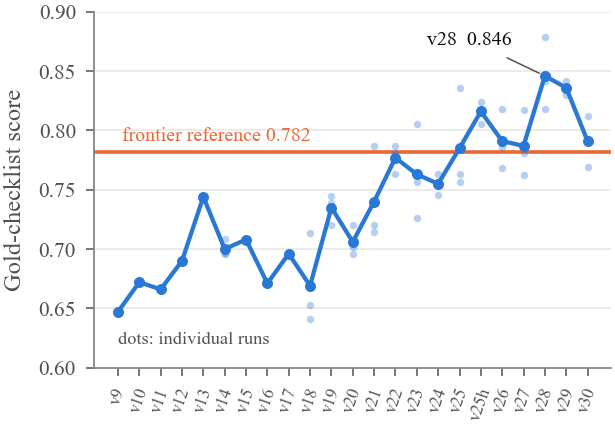
Malý model začínal výrazně pod referencí (0.647 oproti 0.782), překonal ji ve v25 a ve v28 dosáhl 0.846. Všechny tři běhy v28 (0.818, 0.842, 0.879) jsou nad referencí. Dvě pozdější verze v28 nepřekonaly, a cyklus se proto zastavil.
| Anita, před S13 | Anita, před S20 | Markus, před S12 | |
|---|---|---|---|
| v28, průměr ze 3 běhů | 0.963 | 0.800 | 0.776 |
| v28, best-of-3 (verifikátor) | 0.963 | 0.836 | 0.836 |
| reference GPT-5.5 (1 běh) | 0.963 | 0.655 | 0.727 |
Průměry za kontrolní body: v28 0.846 · best-of-3 0.879 · reference 0.782.
Zaslepené hodnocení: v mezích šumu hodnotitele
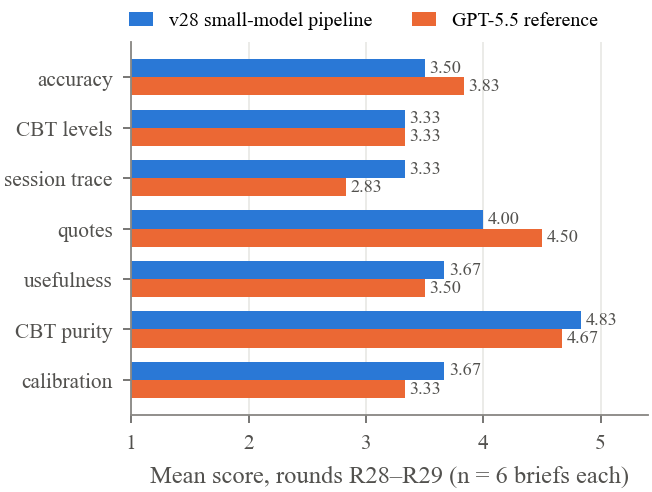
V závěrečných kolech dosáhly nejlepší verze malého modelu a reference skóre 3.77 oproti 3.87 (R28) a 3.77 oproti 3.57 (R29). V šesti párech ze stejného kola byly rozdíly −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: průměr +0.05, SD 0.49. Ani jeden systém nedosáhl cílového průměru supervizora 4.0. Podle kritérií byla v28 lepší ve sledování průběhu sezení a kalibraci, horší v přesnosti (shoda se zlatou referencí) a citacích a vyrovnaná v úrovních KBT.
Náklady
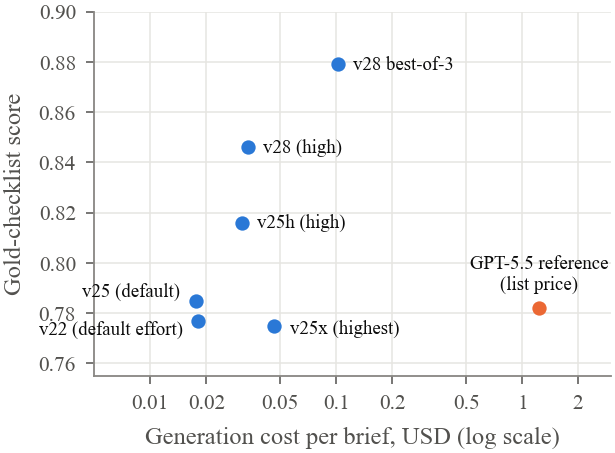
Vytvoření jednoho přehledu v28 stojí přibližně 0,03 USD za psaní jednotlivých oddílů a trvá 2.5–3 minuty; přehled best-of-3 stojí přibližně 0.11 USD. Zpracování nového sezení přidává přibližně 0.07 USD, převážně kvůli průchodu klasifikátoru přes každou větu. Podle ceníkových cen stojí referenční přehled frontier modelu přibližně 19krát více než jeden přehled v28. Celý projekt spotřeboval tokeny malého modelu v hodnotě 5.57 USD.
Co pomohlo a co ne
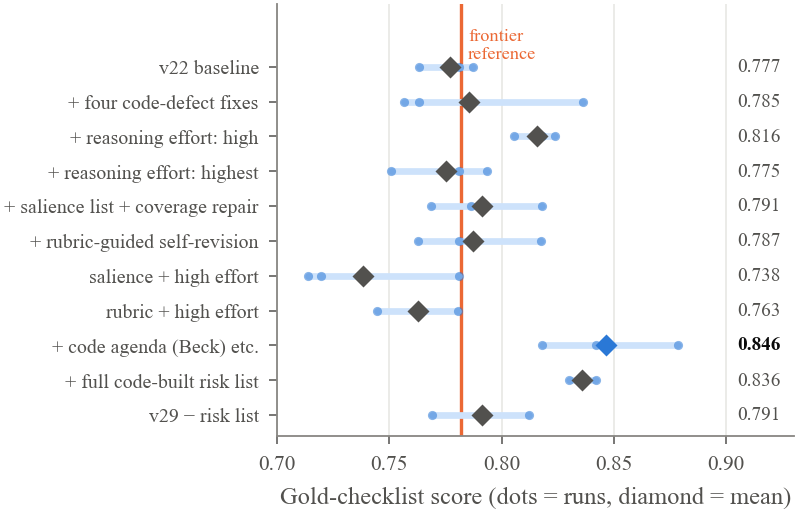
Pomohly tři věci: opravy chyb v deterministickém kódu odhalených supervizorem, vysoké nastavení úsilí při uvažování pro autory oddílů (nejvyšší nastavení bylo dražší a dosáhlo nižšího skóre) a přesun navrhované agendy, lišty předpovědí a nejnovějšího výroku souvisejícího s rizikem do kódu. Několik zdánlivě vhodných doplňků výsledky zhoršilo: sloučení tří návrhů, časová osa přesvědčení určená kódem, nápovědy k významnosti spolu s opravou pokrytí a seberevize řízená hodnoticí rubrikou. Každý z nich přidal krok generování, při němž může malý model informace ztratit nebo zkreslit. Každá změna, která modelu ubrala práci nebo vybírala mezi výstupy, aniž by je přepisovala, byla bezpečná.
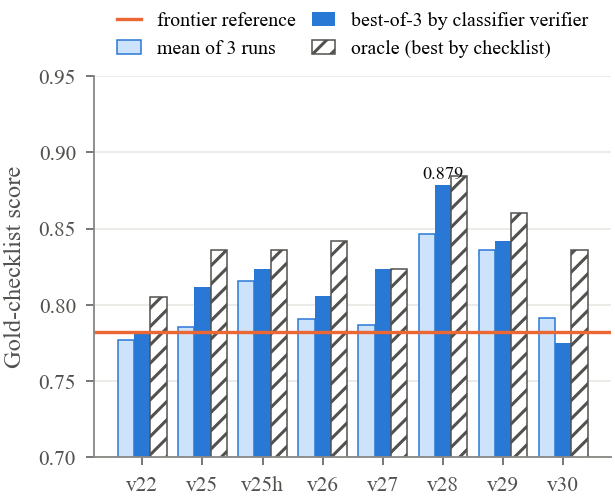
Výběr verifikátorem zlepšil skóre podle kontrolního seznamu u sedmi z osmi verzí; u v28 z 0.846 na 0.879, tedy blízko oracle (0.885). Protože verifikátor a hodnotitel kontrolního seznamu jsou tentýž klasifikátor, část tohoto zlepšení může odrážet společné preference.
Co zůstávalo obtížné
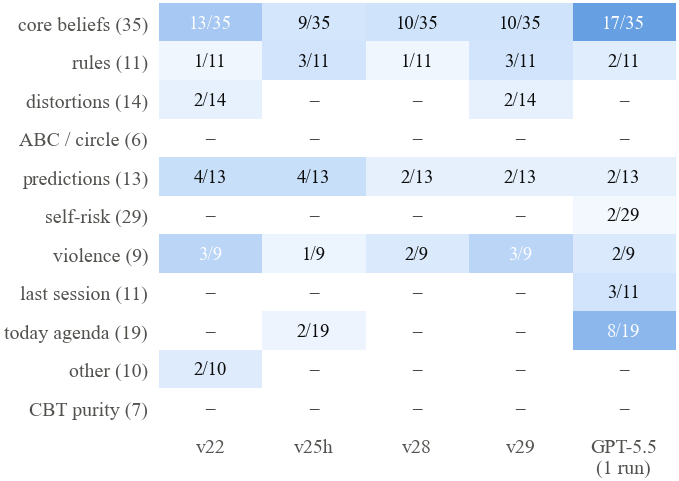
Počet přetrvávajících selhání klesl mezi v22 a v28 z 25 na 15 ze 164 váhových jednotek. Zbývají nejjemnější úsudky kognitivního modelu: stav přesvědčení po jeho opětovné aktivaci, rozsahy přesvědčení končící před nejnovějším materiálem a upřesnění rozsahu platnosti. Nejobtížnější složkou byly výroky o riziku: penalizovalo se jak vynechání nedávného výroku, tak převod metafory, cvičení nebo hodnocení emocí na signál. Nejlepší návrh ponechal pouze nejnovější doslovný výrok a sezení, v němž se na něj terapeut naposledy přímo zeptal, a veškeré interpretace přenechal terapeutovi.
Hodnotitel je součástí experimentu
Protože se referenční přehled nikdy nezměnil, jeho skóre měří pouze výkon supervizora.
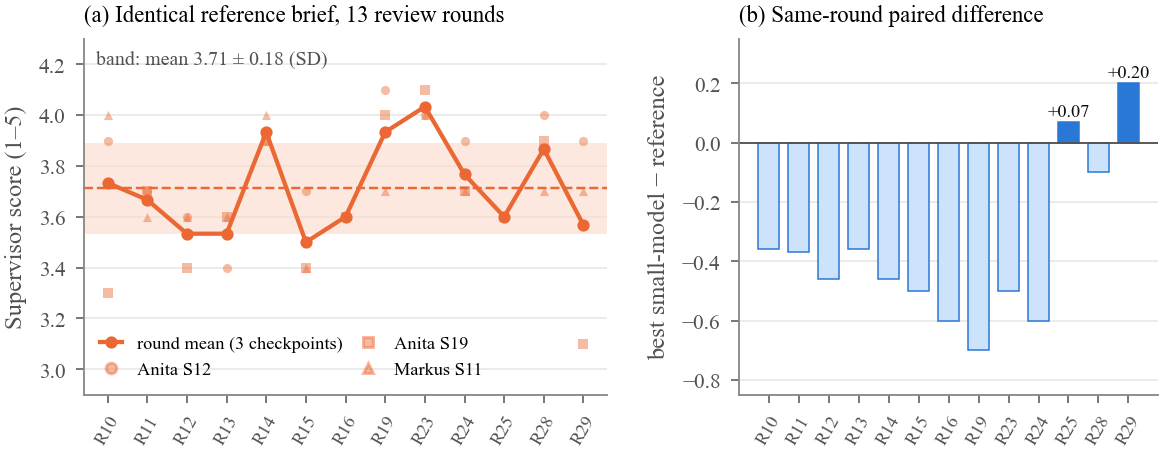
V průběhu 13 kol získal totožný referenční přehled průměrné skóre 3.71 se SD 0.18 a rozsahem 3.50–4.03 na stupnici 1–5. U jednotlivých kritérií dosáhlo SD až 0.46, a to i u citací, jejichž totožnost byla ověřena skriptem a které byly pokaždé stejné. Tento šum je přibližně stejně velký jako celé zlepšení, kterého cyklus dosáhl na stejné stupnici.
Co tato studie neukazuje
- Pouze syntetická data. Dva syntetičtí pacienti, tři kontrolní body, tři běhy na verzi. Pouze deskriptivní statistiky, žádné testy statistické významnosti. Přenositelnost na jiné úlohy a reálný materiál je zdůvodňována, nikoli prokázána.
- Pouze hodnocení založené na modelech. Záměrně se neúčastnili žádní kliničtí pracovníci ani jiní lidští hodnotitelé. Skóre popisují shodu se zlatým kontrolním seznamem a úsudek supervizora LLM, nikoli klinickou kvalitu, bezpečnost ani jakýkoli vliv na terapii.
- Ladění na evaluační sadě. Všechny verze byly vyvíjeny vůči stejným kontrolním bodům a hodnotitelům, takže finální skóre jsou optimistická. Správným testem by byl pacient vyhrazený pro testování.
- Nerozlišitelnost neznamená převahu. Při zaslepeném hodnocení nebylo možné při této velikosti vzorku rozlišit malý model od referenčního frontier modelu; rozdíly spadají do vlastního šumu hodnotitele.
- Sdílený klasifikátor. Hodnotitel kontrolního seznamu, analyzátor vět i verifikátor jsou tentýž model.
- Skromná reference. Referenci frontier modelu tvoří jeden dřívější, neoptimalizovaný běh pipeline, jednou provedený pomocí GPT-5.5; nejde o frontier pipeline laděný stejným cyklem.
Přečtěte si článek, ověřte čísla
Celý článek je zdarma ke stažení. Datový balíček s kontrolními seznamy, skóre a ukázkovými přehledy obdržíte e-mailem.
Článek
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 stran, 9 obrázků.
Stáhnout datový balíček
PDF článku, všech devět obrázků, tři zlaté kontrolní seznamy, skóre kontrolního seznamu a verifikátoru pro každou verzi, zaslepená hodnocení ze závěrečných kol s klíči označenými písmeny a tři finální ukázkové přehledy. Soubor README vysvětluje všechna pole.
Adresy nesdílíme. Odkaz na data dorazí během několika minut.
Co ZIP obsahuje
paper/: článek ve formátu PDFfigures/: devět obrázků a podkladová číslascores/gold_checklists.json: 3 × 25 vážených výrokůscores/checklist_results.json: pravděpodobnosti jednotlivých položek pro 198 hodnocených přehledůscores/blind_review_R28.json,R29: sedm kritérií, verdikty a připomínky s klíči označenými písmenyexample-briefs/: tři finální přehledy v28 (v polštině, stejně jako přepisy)
Neobsahuje: syntetické přepisy, prompty ani kód. Pro výzkumné účely jsou na vyžádání dostupné od autorů.
Jak citovat
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}