Mali model, pažljivo osmišljena cevovodna obrada
Metod autoresearch za smanjivanje razlike u odnosu na frontier LLM-ove pri sažimanju dugih dokumenata i više dokumenata. Testirano na sažecima za pripremu pre seanse, izrađenim na osnovu transkripata dveju sintetičkih pacijenata.
Jeftin model može da se približi, ako radi manje
Frontier jezički modeli dobro sažimaju dugačak materijal iz više dokumenata, ali njihovo pokretanje pre svakog izlaza postaje skupo. Mali modeli su jeftini, ali gube informacije pri obradi dugih ulaza. Ispitali smo dokle može da stigne model niske cene kada je deo pažljivo osmišljene cevovodne obrade i unapređuje se automatizovanim ciklusom koji svaku izmenu evaluira pomoću drugih modela, bez ljudskih ocenjivača.
Tokom više od 30 verzija i 16 rundi slepe recenzije, rezultat malog modela porastao je sa 0,647 na 0,846 na ponderisanoj zlatnoj kontrolnoj listi (0,879 kada se referentno nezavisnim verifikatorom izabere najbolji od tri izlaza). Referentni frontier model ostvario je rezultat 0,782. U slepoj recenziji koju je sproveo LLM nadzornik, ova dva modela nisu se mogla razlikovati na ovom obimu uzorka: srednja vrednost razlike u uparenim poređenjima bila je +0,05 (SD 0,49). Isti, neizmenjeni referentni sažetak dobio je ocene između 3,50 i 4,03 od tog nadzornika tokom 13 rundi, pa se pokazalo da je i sopstvena varijabilnost ocenjivača važan nalaz.
Sadržaj
Dug ulaz, fiksna struktura, rutinska upotreba
Mnogi praktični zadaci sažimanja imaju tri zajednička svojstva: ulaz je dug i rasut kroz više dokumenata, izlaz prati fiksnu strukturu koja sadrži brojeve, datume i doslovne dokaze, a izlaz se izrađuje rutinski, pa je trošak važan.
Kao probni zadatak koristili smo jedan takav primer: strukturisani sažetak koji KBT terapeut može da pročita za oko tri minuta pre seanse. U njemu su navedena osnovna uverenja sa brojem seansi, pravila, ponavljajuće distorzije, tipične ABC epizode, proverena predviđanja, poslednja seansa i tačke koje bi terapeut mogao da pokrene na današnjoj seansi. Do 20. seanse materijal ima oko 130.000 reči.
Ovaj zadatak odgovara metodološkom pitanju jer ima poznatu strukturu (Bekov kognitivni model), prirodnu mogućnost proveravanja dokaza (doslovne reči pacijenta) i nekoliko zamki: uverenje koje je prvo formulisao terapeut ili metafora koja nije izjava o smrti.
Dve sintetičke pacijentkinje
Obe pacijentkinje generisane su našom slojevitom metodom za sintetičke pacijente (najpre listom profila, terapijskim tokom, planom seansi i vodičem za glas, a zatim generisanjem seansi jednu po jednu, u obliku transkripata nalik ASR-u). Anita: 20 seansi, 131.498 reči, KBT u stilu J. Beck. Markus: 12 seansi, 83.978 reči, uz terapeuta koji delimično primenjuje šematsku terapiju, pa sažetak mora da prevede materijal nazad u okvire KBT-a. Za svakog pacijenta zlatni referentni sažetak sastavljen je nezavisno, na osnovu čitanja celokupnih transkripata. Nisu korišćeni podaci stvarnih pacijenata.
Podela zadataka
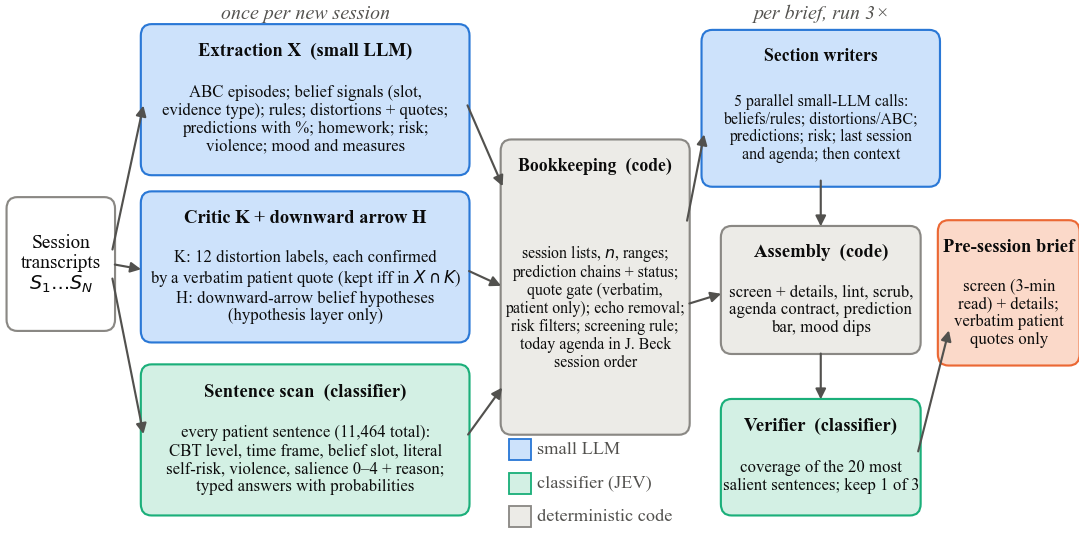
Presudne izmene nisu bile bolji promptovi, već drugačija raspodela odgovornosti. Svaka komponenta radi samo ono u čemu je dobra.
Deterministički kod
Sve što može da se prebroji, poređa ili proveri
Liste seansi, brojanja i opsezi za svako uverenje; lanci predviđanja povezani između seansi; provera doslovnih citata koja odbacuje svaki citat koji nije pronađen u sopstvenim replikama pacijenta; uklanjanje terapeutovih ponavljanja; i, počev od verzije 28, redosled predloženih tema za današnju seansu. Kada se otkrije greška u ovom kodu, ona se ispravlja trajno.
Klasifikator rečenica
Procene za koje nije potrebno generisanje teksta
Svaka rečenica pacijenta (ukupno 11.464) dobija po jednu oznaku: nivo KBT-a (automatska misao, pravilo, uverenje, emocija, ponašanje…), vremenski okvir (sada ili prisećanje), doslovno ili figurativno izražavanje i moguću relevantnost rečenice za narednu seansu, svaka sa verovatnoćom. Isti klasifikator kasnije služi kao referentno nezavisan verifikator i kao ocenjivač kontrolne liste.
Mali jezički model
Kratko pisanje na osnovu pripremljenog materijala
Za svaku seansu mali model izdvaja strukturu, potvrđuje distorzije doslovnim citatima i predlaže hipoteze (koje se čuvaju kao hipoteze, nikada kao dokazi). Za svaki sažetak, pet autora odeljaka radi paralelno; svaki vidi samo podatke označene brojevima seansi za svoj odeljak i dobija uputstvo da nikada ne izmišlja brojeve seansi ni citate.
Najbolji od tri, bez uvida u odgovor
Razlike između pokretanja iste verzije često su bile veće od razlika među verzijama. Zato se cevovodna obrada sažetka pokreće tri puta, a verifikator bira jedan izlaz: uzima 20 najrelevantnijih rečenica pacijenta i pita klasifikator da li se svaka od njih odražava u sažetku. Verifikatoru nisu dostupni zlatni referentni sažetak ni kontrolna lista.
Autoresearch ciklus
Automatizovani razvojni ciklus u duhu novijih radova o automatizovanom eksperimentisanju: predložiti jednu izmenu, pokrenuti je i zadržati samo ako se slože dve nezavisne metrike.
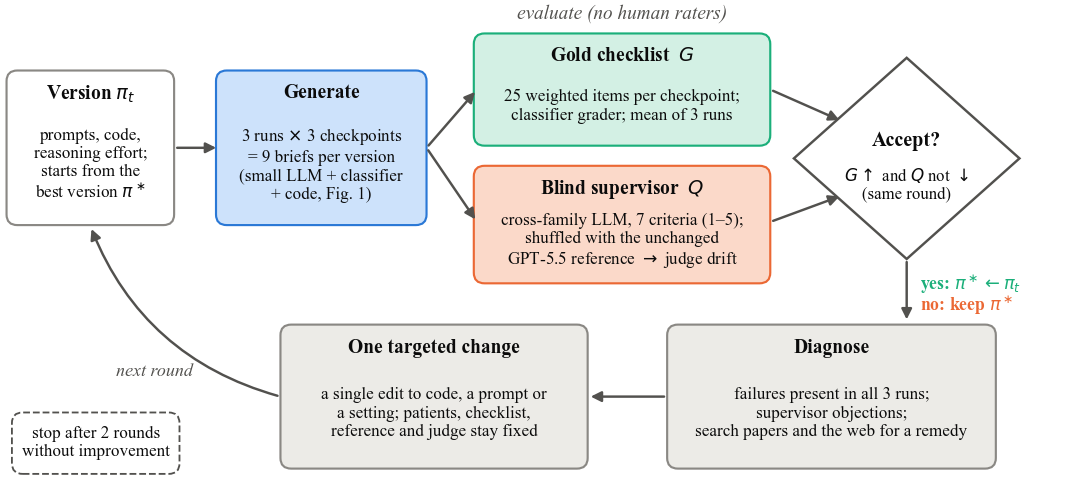
- Dve metrike. Zlatna kontrolna lista sa 25 ponderisanih tvrdnji po kontrolnoj tački, koju ocenjuje klasifikator, i slepa recenzija koju sprovodi LLM nadzornik iz druge porodice modela, ocenjujući sedam kriterijuma na skali od 1 do 5.
- Fiksna referenca. Nadzornik uvek dobija i jedan neizmenjeni frontier referentni sažetak, označen nasumičnim slovom, čime se u svakoj rundi meri sopstveno odstupanje ocenjivača.
- Jedna izmena odjednom. Greške prisutne u sva tri pokretanja i primedbe nadzornika služe za usmeravanje jedne ciljane izmene po rundi, uz podršku pretrage literature.
- Fiksno pravilo zaustavljanja. Dve uzastopne runde bez poboljšanja završavaju ciklus. Zaustavljen je na v28.
- Fiksna gornja granica troška. U cevovodnoj obradi ne sme da se koristi nijedan model skuplji od malog modela ili klasifikatora.
Šta smo uočili
Deskriptivna statistika na tri kontrolne tačke (Anita pre 13. i 20. seanse, Markus pre 12. seanse) i tri pokretanja po verziji.
Obuhvat sadržaja: zlatna kontrolna lista
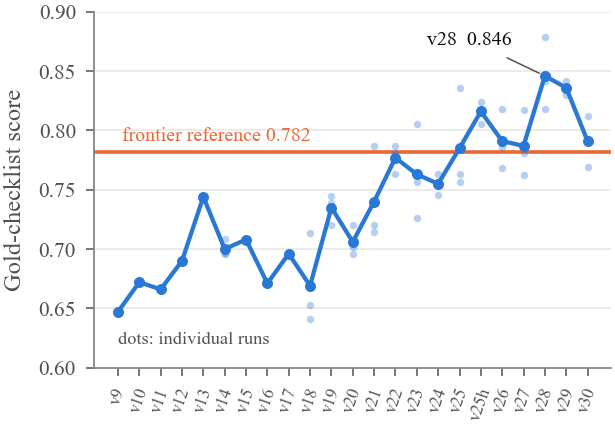
Mali model je počeo znatno ispod reference (0,647 naspram 0,782), premašio je njen rezultat na v25 i dostigao 0,846 na v28. Sva tri pokretanja v28 (0,818, 0,842, 0,879) ostvarila su rezultat iznad reference. Dve kasnije verzije nisu nadmašile v28, pa je ciklus zaustavljen.
| Anita, pre S13 | Anita, pre S20 | Markus, pre S12 | |
|---|---|---|---|
| v28, prosek 3 pokretanja | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifikator) | 0,963 | 0,836 | 0,836 |
| GPT-5.5 referenca (1 pokretanje) | 0,963 | 0,655 | 0,727 |
Proseci preko kontrolnih tačaka: v28 0,846 · best-of-3 0,879 · referenca 0,782.
Slepa recenzija: unutar varijabilnosti ocenjivača
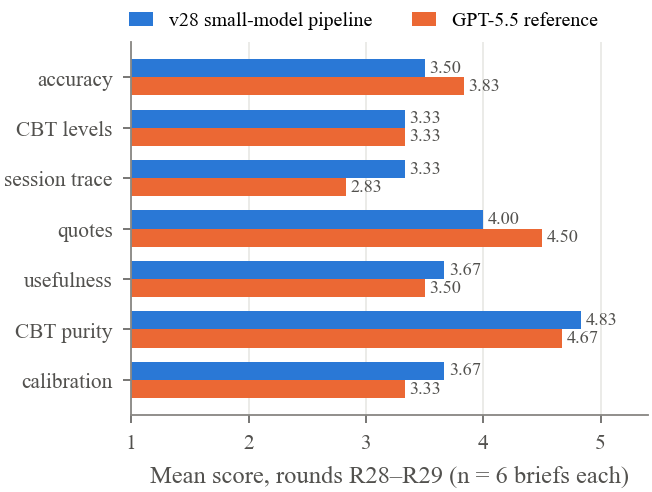
U završnim rundama najbolja verzija malog modela i referenca dobile su ocene 3,77 naspram 3,87 (R28) i 3,77 naspram 3,57 (R29). U šest poređenja u istoj rundi razlike su bile −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: srednja vrednost +0,05, SD 0,49. Nijedan sistem nije dostigao ciljnu prosečnu ocenu nadzornika od 4,0. Po kriterijumu, v28 je bio bolji u praćenju toka seansi i kalibraciji, lošiji u tačnosti (podudaranju sa zlatnim referentnim sažetkom) i citatima, a izjednačen u nivoima KBT-a.
Trošak
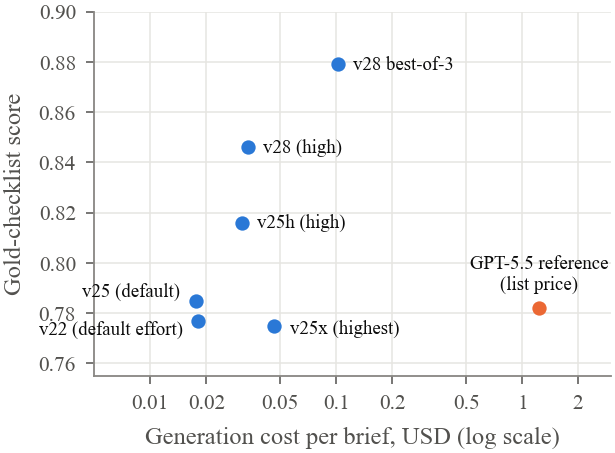
Izrada jednog sažetka v28 košta oko 0,03 USD za pisanje odeljaka i traje 2,5–3 minuta; sažetak best-of-3 košta oko 0,11 USD. Obrada nove seanse dodaje oko 0,07 USD, uglavnom zbog prolaza klasifikatora kroz svaku rečenicu. Prema kataloškim cenama, referentni frontier sažetak košta oko 19 puta više od jednog sažetka v28. Za ceo projekat potrošeno je 5,57 USD na tokene malog modela.
Šta je pomoglo, a šta nije
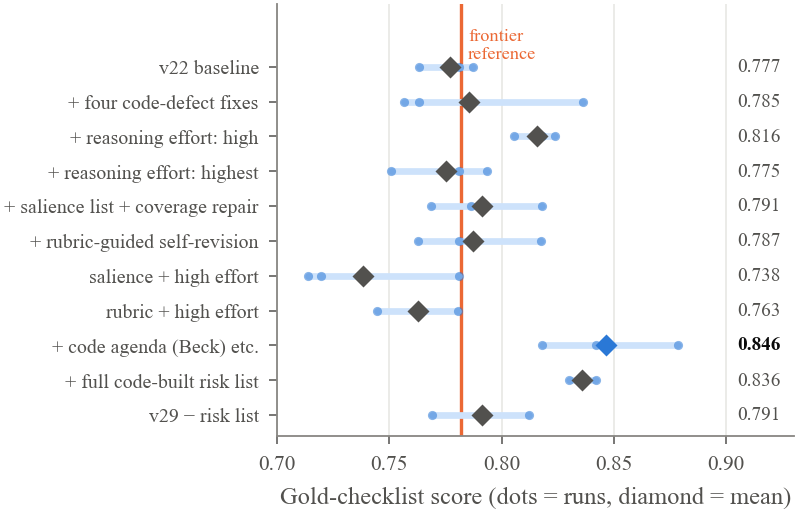
Pomogle su tri stvari: ispravljanje nedostataka u determinističkom kodu koje je otkrio nadzornik, visoko podešavanje intenziteta rezonovanja za autore odeljaka (najviše podešavanje koštalo je više i ostvarilo niži rezultat) i premeštanje predloženog dnevnog reda, trake predviđanja i najnovije izjave povezane s rizikom u kod. Nekoliko naizgled verovatnih dodataka imalo je negativan učinak: spajanje tri nacrta, vremenska linija uverenja nametnuta kodom, naznake o relevantnosti uz naknadni prolaz za popravku obuhvata i samorevizija vođena rubrikom. Svaki od njih dodao je korak generisanja u kojem mali model može da izgubi ili izobliči informacije. Svaka izmena koja je modelu oduzimala deo posla ili birala među izlazima bez njihovog prepisivanja bila je bezbedna.
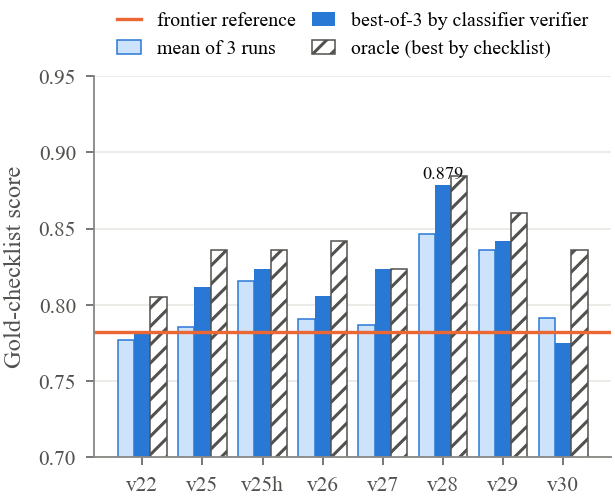
Izbor verifikatora poboljšao je rezultat na kontrolnoj listi u sedam od osam verzija; za v28 sa 0,846 na 0,879, što je blizu orakla (0,885). Pošto su verifikator i ocenjivač kontrolne liste isti klasifikator, deo ovog dobitka možda odražava zajedničke preferencije.
Šta je i dalje teško
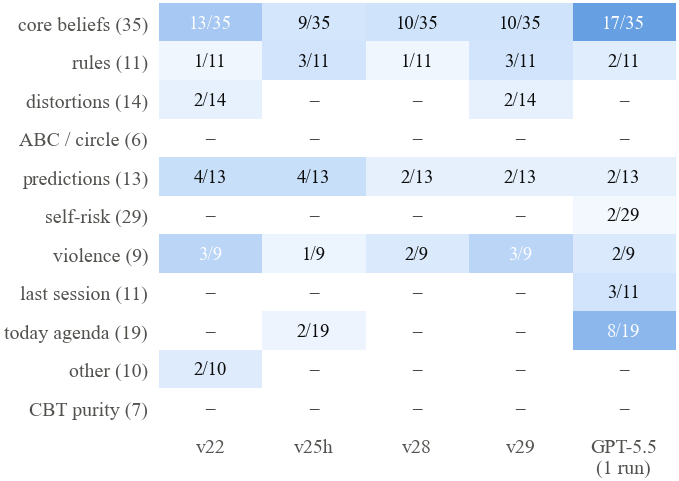
Broj trajnih grešaka smanjio se sa 25 na 15 od ukupno 164 ponderisane jedinice između v22 i v28. Preostaju najistančanije procene kognitivnog modela: stanje uverenja nakon što se ponovo aktivira, opsezi uverenja koji se završavaju pre najnovijeg materijala i ograničenja opsega. Iskazi o riziku bili su najteža komponenta: kažnjavani su i izostavljanje nedavne izjave i pretvaranje metafore, vežbe ili ocene emocije u signal. Najbolje osmišljeno rešenje zadržalo je samo najnoviju doslovnu izjavu i seansu tokom koje je terapeut poslednji put direktno pitao o njoj, a svako tumačenje prepustilo terapeutu.
Ocenjivač je deo eksperimenta
Budući da se referentni sažetak nikada nije menjao, njegove ocene mere samo rad nadzornika.
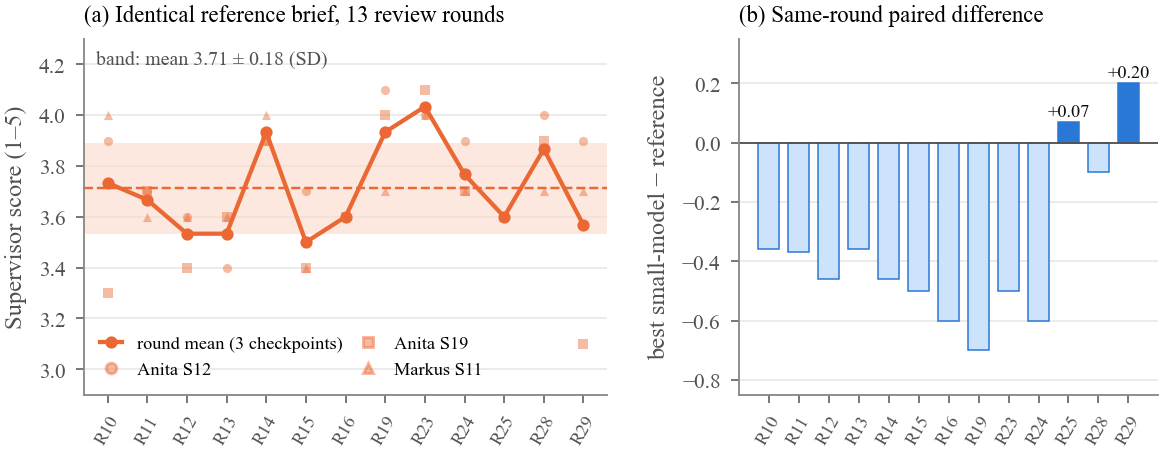
Tokom 13 rundi, prosečna ocena identičnog referentnog sažetka po rundi iznosila je 3,71, uz SD 0,18 i raspon od 3,50–4,03 na skali od 1 do 5. Kod pojedinačnih kriterijuma SD je dostigla 0,46, uključujući i citate koji su bili provereni skriptom i svaki put identični. Ta varijabilnost približno je jednaka celокупном poboljšanju koje je ciklus ostvario na istoj skali.
Šta ova studija ne pokazuje
- Samo sintetički podaci. Dve sintetičke pacijentkinje, tri kontrolne tačke, tri pokretanja po verziji. Samo deskriptivna statistika, bez testova značajnosti. Prenos rezultata na druge zadatke i stvarni materijal je obrazložen, ali nije prikazan.
- Samo evaluacija zasnovana na modelima. Po dizajnu nisu učestvovali kliničari ni drugi ljudski ocenjivači. Ocene opisuju podudaranje sa zlatnom kontrolnom listom i procenu LLM nadzornika, a ne klinički kvalitet, bezbednost ili bilo kakav uticaj na terapiju.
- Podešavanje na skupu za evaluaciju. Sve verzije razvijane su u odnosu na iste kontrolne tačke i ocenjivače, pa su završni rezultati optimistični. Pacijent koji nije korišćen pri razvoju bio bi odgovarajući test.
- Nemogućnost razlikovanja ne znači da je nešto bolje. U slepoj recenziji mali model i frontier referenca nisu se mogli razlikovati na ovom obimu uzorka; razlike su unutar sopstvene varijabilnosti ocenjivača.
- Zajednički klasifikator. Ocenjivač kontrolne liste, skener rečenica i verifikator isti su model.
- Skromna referenca. Frontier referenca je jedno ranije, neoptimizovano pokretanje cevovodne obrade pomoću GPT-5.5, a ne frontier cevovodna obrada podešena istim ciklusom.
Pročitajte rad, proverite brojke
Ceo rad može besplatno da se preuzme. Paket podataka sa kontrolnim listama, rezultatima i primerima sažetaka stiže imejlom.
Rad
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 stranica, 9 grafikona.
Preuzmite paket podataka
PDF rada, svih devet grafikona, tri zlatne kontrolne liste, rezultati kontrolne liste i verifikatora za svaku verziju, slepe recenzije iz završnih rundi sa njihovim slovnim oznakama i tri završna primera sažetaka. Datoteka README objašnjava svako polje.
Ne delimo imejl adrese. Veza ka podacima stiže za nekoliko minuta.
Sadržaj ZIP arhive
paper/: rad u PDF formatufigures/: devet grafikona i brojke na kojima se zasnivajuscores/gold_checklists.json: 3 × 25 ponderisanih tvrdnjiscores/checklist_results.json: verovatnoće za pojedinačne stavke za 198 ocenjenih sažetakascores/blind_review_R28.json,R29: sedam kriterijuma, presude i primedbe, sa slovnim oznakamaexample-briefs/: tri završna sažetka v28 (na poljskom, kao i transkripti)
Nije uključeno: sintetički transkripti, promptovi i kod. Dostupni su od autora na zahtev za potrebe istraživanja.
Kako citirati
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}