Kleines Modell, sorgfältige Pipeline
Eine Autoresearch-Methode, um bei der Zusammenfassung langer Dokumente aus mehreren Quellen den Abstand zu Frontier-LLMs zu verringern. Getestet anhand von Sitzungsbriefings auf Basis der Transkripte zweier synthetischer Patienten.
Ein günstiges Modell kann nahe herankommen – wenn es weniger tut
Frontier-Sprachmodelle fassen lange Materialien aus mehreren Dokumenten gut zusammen, doch sie vor jeder Ausgabe einzusetzen, wird teuer. Kleine Modelle sind günstig, verlieren aber bei langen Eingaben Informationen. Wir untersuchten, wie weit ein kostengünstiges Modell kommen kann, wenn es in eine sorgfältig entwickelte Pipeline eingebettet und durch einen automatisierten Zyklus verbessert wird, der jede Änderung mithilfe anderer Modelle evaluiert – ohne menschliche Beurteilende.
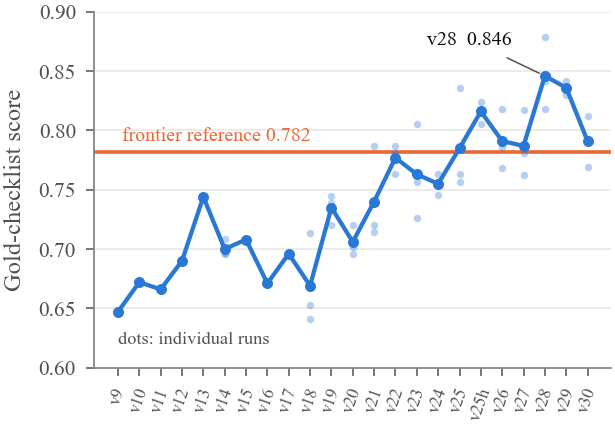
Über 30 Versionen und 16 verblindete Bewertungsrunden stieg der Wert des kleinen Modells auf einer gewichteten Gold-Checkliste von 0,647 auf 0,846 (0,879, wenn ein referenzfreier Verifier den besten von drei Durchläufen auswählt). Die Frontier-Referenz erreichte 0,782. Bei der verblindeten Bewertung durch eine LLM-Aufsichtsperson waren die beiden bei dieser Stichprobengröße nicht voneinander zu unterscheiden: Die mittlere gepaarte Differenz betrug +0,05 (SD 0,49). Dasselbe unveränderte Referenzbriefing erhielt von dieser Aufsichtsperson über 13 Runden hinweg Werte zwischen 3,50 und 4,03 – das Eigenrauschen der beurteilenden Instanz erwies sich somit als eigenständiger Befund.
Inhalt
Lange Eingabe, feste Struktur, routinemäßiger Einsatz
Viele praktische Zusammenfassungsaufgaben haben drei gemeinsame Merkmale: Die Eingabe ist lang und über viele Dokumente verteilt, die Ausgabe folgt einer festen Struktur mit Zählwerten, Daten und wörtlichen Belegen, und sie wird regelmäßig erstellt, sodass die Kosten eine Rolle spielen.
Als Testfall verwendeten wir eine solche Aufgabe: ein strukturiertes Briefing, das eine CBT-Therapeutin vor einer Sitzung in etwa drei Minuten lesen kann. Es führt zentrale Überzeugungen mit der Zahl der Sitzungen, Regeln, wiederkehrende Verzerrungen, typische ABC-Episoden, überprüfte Vorhersagen, die letzte Sitzung und mögliche Themen für die heutige Sitzung auf. Bis zur 20. Sitzung umfasst das Material etwa 130.000 Wörter.
Die Aufgabe eignet sich für eine Methodenfrage, weil sie eine bekannte Struktur hat (Becks kognitives Modell), einen natürlichen Begriff überprüfbarer Belege (die wörtlichen Äußerungen der Patient:innen) und mehrere Fallstricke: eine Überzeugung, die ursprünglich von der Therapeutin formuliert wurde, oder eine Metapher, die keine Aussage über den Tod ist.
Zwei synthetische Patient:innen
Beide Patient:innen wurden mit unserer mehrschichtigen Methode zur Generierung synthetischer Patient:innen erstellt (zunächst Profilbogen, therapeutischer Verlauf, Sitzungsplan und Leitfaden zur Sprechweise, anschließend einzelne Sitzungen als ASR-artige Transkripte). Anita: 20 Sitzungen, 131.498 Wörter, CBT im Stil von J. Beck. Markus: 12 Sitzungen, 83.978 Wörter; seine Therapeutin arbeitet teilweise mit Schematherapie, daher muss das Briefing das Material wieder in CBT-Begriffe übertragen. Für jede:n Patient:in wurde unabhängig anhand der vollständigen Transkripte eine Goldreferenz erstellt. Es wurden keine realen Patientendaten verwendet.
Arbeitsteilung
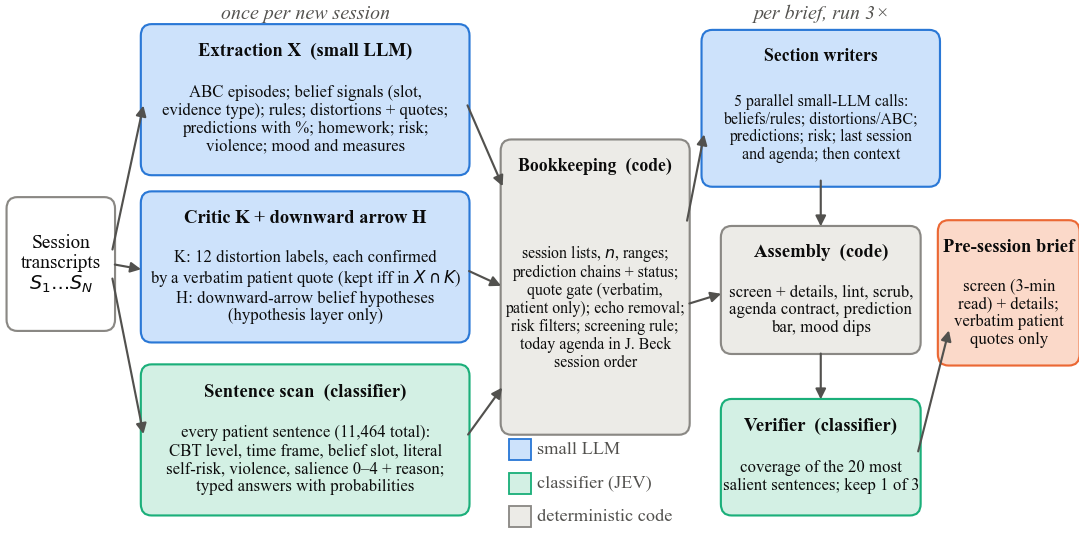
Die entscheidenden Änderungen bestanden nicht in besseren Prompts, sondern in einer Neuverteilung der Aufgaben. Jede Komponente übernimmt nur das, worin sie gut ist.
Deterministischer Code
Alles, was gezählt, geordnet oder überprüft werden kann
Sitzungslisten, Zählwerte und Spannweiten für jede Überzeugung; über Sitzungen hinweg verknüpfte Vorhersageketten; eine Schranke für wörtliche Zitate, die jedes Zitat verwirft, das nicht in den eigenen Äußerungen der Patient:innen vorkommt; das Entfernen von Wiederholungen durch die Therapeutin; und ab Version 28 die Reihenfolge der vorgeschlagenen Punkte für die heutige Sitzung. Sobald ein Fehler in diesem Code gefunden wird, bleibt er behoben.
Ein Satzklassifikator
Beurteilungen, für die keine Textgenerierung nötig ist
Jeder Satz der Patient:innen (insgesamt 11.464) wird einmal klassifiziert: CBT-Ebene (automatischer Gedanke, Regel, Überzeugung, Emotion, Verhalten …), Zeitbezug (aktuell oder erinnert), wörtliche oder bildhafte Formulierung sowie mögliche Relevanz des Satzes für die nächste Sitzung – jeweils mit einer Wahrscheinlichkeit. Derselbe Klassifikator dient später als referenzfreier Verifier und als Bewerter der Checkliste.
Ein kleines Sprachmodell
Kurze Texte auf Basis vorbereiteten Materials
Pro Sitzung extrahiert das kleine Modell Strukturen, bestätigt Verzerrungen anhand wörtlicher Zitate und schlägt Hypothesen vor (die als Hypothesen gespeichert werden, niemals als Belege). Pro Briefing laufen fünf Abschnittsautor:innen parallel; jede:r sieht nur die sitzungsnummerierten Daten des eigenen Abschnitts und erhält die Anweisung, niemals Sitzungsnummern oder Zitate zu erfinden.
Der beste von drei Durchläufen – ohne die Antwort zu sehen
Die Unterschiede zwischen Durchläufen innerhalb einer Version waren häufig größer als die Unterschiede zwischen Versionen. Daher wird die Briefing-Pipeline auf Ebene des gesamten Briefings dreimal ausgeführt; ein Verifier wählt dann ein Ergebnis aus: Er nimmt die 20 salientesten Sätze der Patient:innen und lässt den Klassifikator beurteilen, ob jeder davon im Briefing aufgegriffen wird. Der Verifier sieht weder die Goldreferenz noch die Checkliste.
Der Autoresearch-Zyklus
Ein automatisierter Entwicklungszyklus im Sinne aktueller Arbeiten zu automatisierten Experimenten: eine Änderung vorschlagen, ausführen und nur dann beibehalten, wenn zwei unabhängige Metriken übereinstimmen.
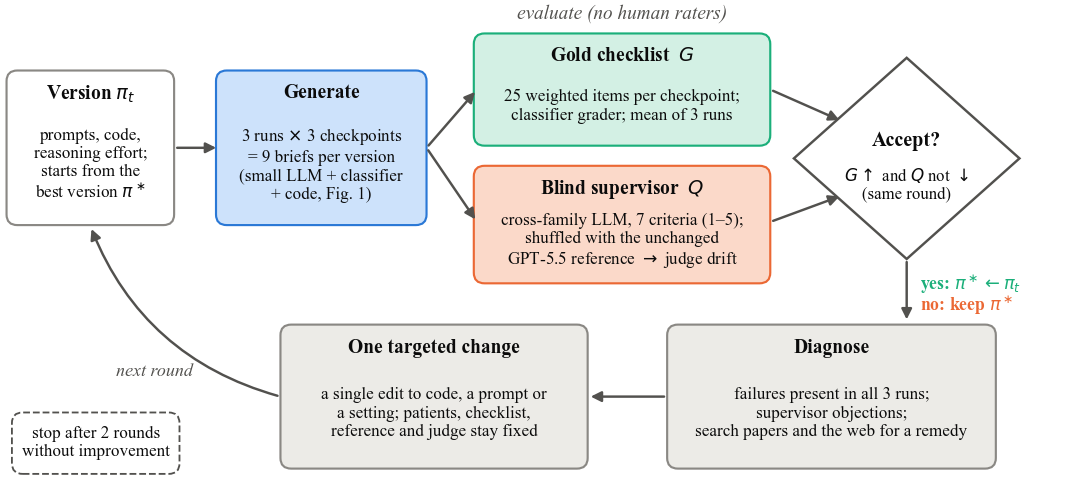
- Zwei Metriken. Eine Gold-Checkliste mit 25 gewichteten Aussagen pro Kontrollpunkt, bewertet durch den Klassifikator, sowie eine verblindete Bewertung durch eine LLM-Aufsichtsperson aus einer anderen Modellfamilie, die sieben Kriterien auf einer Skala von 1–5 bewertet.
- Ein fester Anker. Die Aufsichtsperson sieht außerdem immer ein unverändertes Frontier-Referenzbriefing unter einem zufälligen Buchstaben, sodass die eigene Verschiebung der beurteilenden Instanz in jeder Runde gemessen wird.
- Eine Änderung nach der anderen. Fehler, die in allen drei Durchläufen auftreten, und Einwände der Aufsichtsperson begründen pro Runde eine gezielte Änderung, gestützt durch eine Literaturrecherche.
- Eine feste Abbruchregel. Zwei aufeinanderfolgende Runden ohne Verbesserung beenden den Zyklus. Er endete bei v28.
- Eine feste Kostengrenze. Innerhalb der Pipeline darf kein Modell eingesetzt werden, das teurer ist als das kleine Modell oder der Klassifikator.
Was wir beobachtet haben
Deskriptive Statistiken zu drei Kontrollpunkten (Anita vor den Sitzungen 13 und 20, Markus vor Sitzung 12) und drei Durchläufen pro Version.
Inhaltliche Abdeckung: die Gold-Checkliste
Das kleine Modell startete deutlich unter der Referenz (0,647 gegenüber 0,782), übertraf sie bei v25 und erreichte bei v28 0,846. Alle drei v28-Durchläufe (0,818, 0,842, 0,879) liegen über der Referenz. Zwei spätere Versionen verbesserten v28 nicht, und der Zyklus wurde beendet.
| Anita, vor S13 | Anita, vor S20 | Markus, vor S12 | |
|---|---|---|---|
| v28, Mittelwert aus 3 Durchläufen | 0,963 | 0,800 | 0,776 |
| v28, bester von 3 (Verifier) | 0,963 | 0,836 | 0,836 |
| GPT-5.5-Referenz (1 Durchlauf) | 0,963 | 0,655 | 0,727 |
Mittelwerte über Kontrollpunkte: v28 0,846 · Best-of-3 0,879 · Referenz 0,782.
Verblindete Bewertung: innerhalb des Eigenrauschens der beurteilenden Instanz
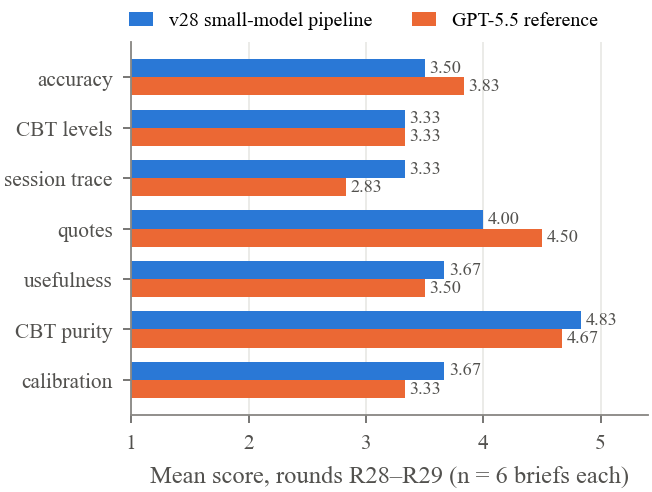
In den letzten Runden erzielten die beste Version des kleinen Modells und die Referenz Werte von 3,77 gegenüber 3,87 (R28) und 3,77 gegenüber 3,57 (R29). Über sechs Paare aus derselben Runde betrug die Differenz −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: im Mittel +0,05, SD 0,49. Keines der beiden Systeme erreichte den angestrebten Durchschnittswert der Aufsichtsperson von 4,0. Bei den einzelnen Kriterien lag v28 bei Sitzungsverlauf und Kalibrierung vorn, bei Genauigkeit (Übereinstimmung mit der Goldreferenz) und Zitaten zurück und bei CBT-Ebenen gleichauf.
Kosten
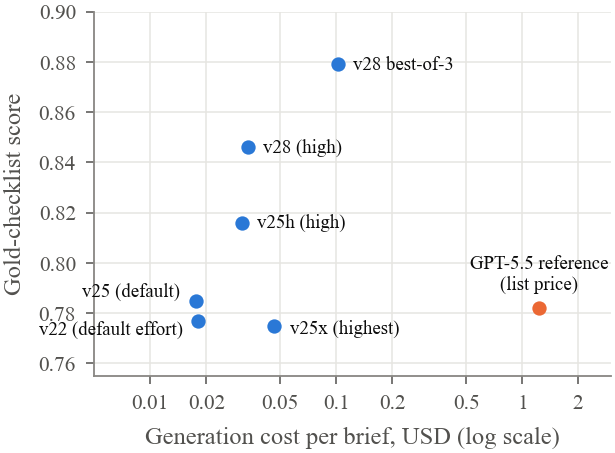
Ein v28-Briefing kostet für das Schreiben der Abschnitte etwa 0,03 USD und benötigt 2,5–3 Minuten; ein Best-of-3-Briefing kostet etwa 0,11 USD. Die Verarbeitung einer neuen Sitzung kostet zusätzlich etwa 0,07 USD, überwiegend für den Klassifikatorlauf über alle Sätze. Zu Listenpreisen kostet ein Briefing mit der Frontier-Referenz etwa 19-mal so viel wie ein einzelnes v28-Briefing. Für das gesamte Projekt wurden 5,57 USD an Tokens des kleinen Modells verwendet.
Was geholfen hat – und was nicht
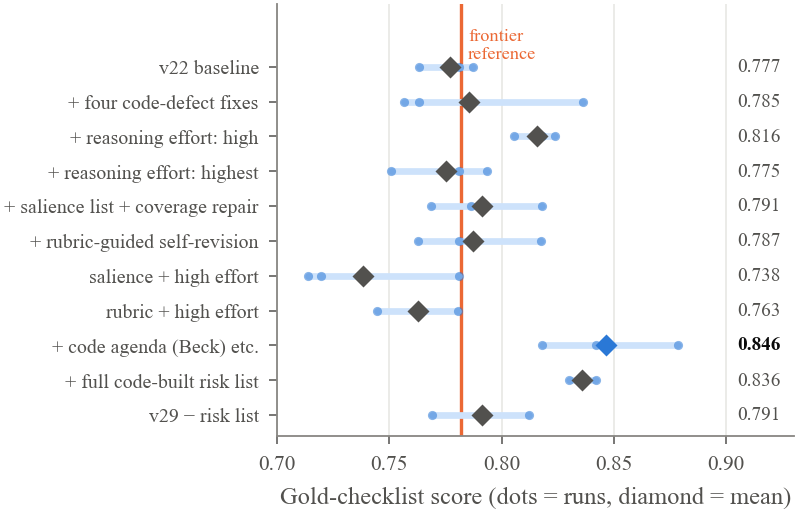
Drei Dinge halfen: die Behebung von Fehlern im deterministischen Code, die von der Aufsichtsperson gefunden wurden; eine hohe Einstellung für den Reasoning-Aufwand der Abschnittsautor:innen (die höchste Einstellung war teurer und erzielte niedrigere Werte); sowie die Verlagerung der vorgeschlagenen Tagesordnung, der Vorhersageleiste und der jüngsten risikobezogenen Aussage in den Code. Mehrere plausible Ergänzungen schadeten: das Zusammenführen von drei Entwürfen, eine codebasierte Zeitleiste für Überzeugungen, Salienz-Hinweise mit einem Durchlauf zur Behebung von Abdeckungslücken und eine rubrikengestützte Selbstüberarbeitung. Jede davon fügte einen Generierungsschritt hinzu, in dem ein kleines Modell Informationen verlieren oder verzerren kann. Jede Änderung, die dem Modell Arbeit abnahm oder Ausgaben auswählte, ohne sie neu zu formulieren, war unbedenklich.
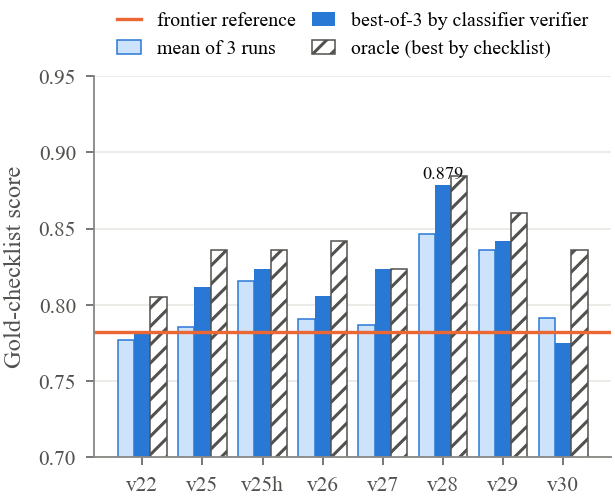
Die Auswahl durch den Verifier verbesserte den Checklistenwert bei sieben von acht Versionen; bei v28 von 0,846 auf 0,879 und damit nahe am Orakelwert (0,885). Da Verifier und Checklistenbewerter derselbe Klassifikator sind, könnte ein Teil dieses Zugewinns auf gemeinsame Präferenzen zurückzuführen sein.
Was weiterhin schwierig blieb
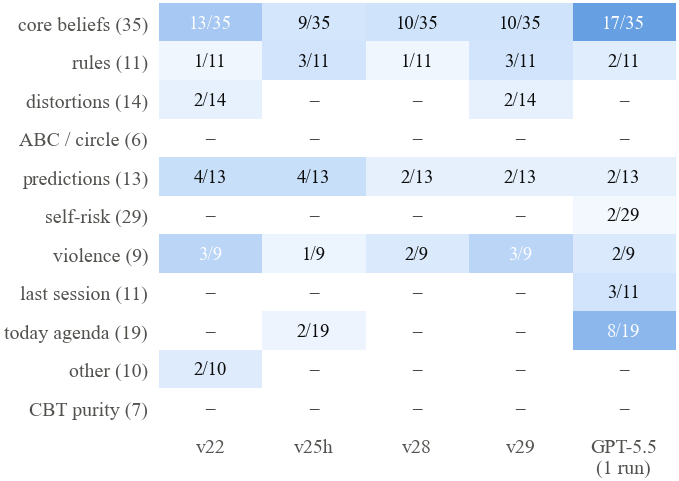
Die anhaltenden Fehler gingen zwischen v22 und v28 von 25 auf 15 von 164 Gewichtungseinheiten zurück. Übrig bleiben die subtilsten Beurteilungen des kognitiven Modells: der Zustand einer Überzeugung nach ihrer Reaktivierung, Spannweiten von Überzeugungen, die vor dem jüngsten Material enden, und Einschränkungen ihres Geltungsbereichs. Aussagen zu Risiken waren die schwierigste Komponente: Sowohl das Übersehen einer jüngsten Aussage als auch die Umdeutung einer Metapher, einer Übung oder einer Bewertung einer Emotion zu einem Signal wurden negativ bewertet. Im besten Design wurde nur die jüngste wörtliche Aussage und die Sitzung beibehalten, in der die Therapeutin zuletzt direkt danach gefragt hatte; jede Interpretation blieb der Therapeutin überlassen.
Die beurteilende Instanz ist Teil des Experiments
Da sich das Referenzbriefing nie änderte, messen seine Bewertungen ausschließlich die Aufsichtsperson.
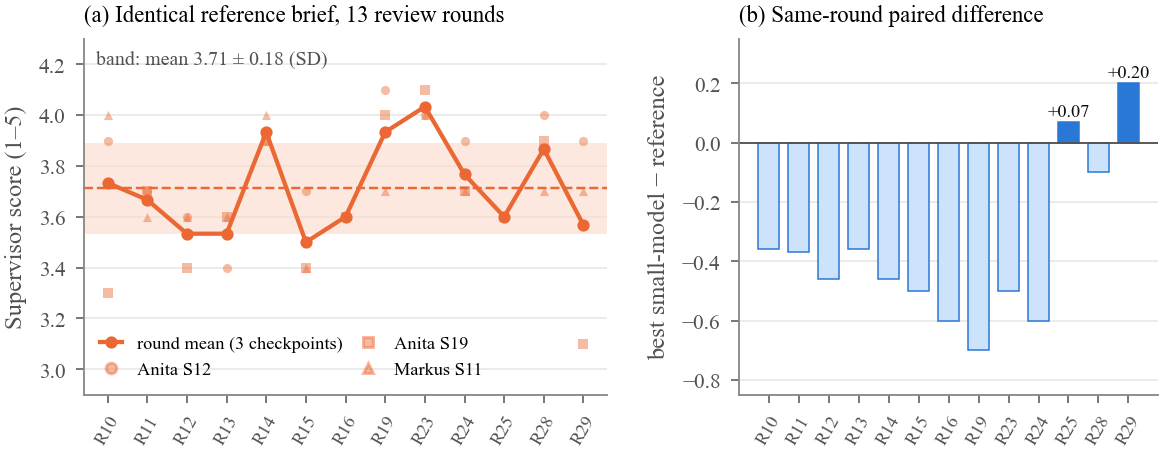
Über 13 Runden hinweg erhielt das identische Referenzbriefing einen Rundenmittelwert von 3,71 bei einer SD von 0,18 und eine Spannweite von 3,50–4,03 auf einer Skala von 1–5. Bei einzelnen Kriterien erreichte die SD 0,46, auch bei Zitaten, die skriptbasiert überprüft wurden und jedes Mal identisch waren. Dieses Rauschen ist etwa so groß wie die gesamte Verbesserung, die der Zyklus auf derselben Skala hervorbrachte.
Was diese Studie nicht zeigt
- Ausschließlich synthetische Daten. Zwei synthetische Patient:innen, drei Kontrollpunkte, drei Durchläufe pro Version. Nur deskriptive Statistiken, keine Signifikanztests. Die Übertragbarkeit auf andere Aufgaben und reales Material wird argumentiert, aber nicht gezeigt.
- Ausschließlich modellbasierte Evaluation. Wie beabsichtigt waren keine Kliniker:innen oder anderen menschlichen Beurteilenden beteiligt. Die Werte beschreiben die Übereinstimmung mit einer Gold-Checkliste und dem Urteil einer LLM-Aufsichtsperson, nicht die klinische Qualität, Sicherheit oder irgendeine Wirkung auf die Therapie.
- Abstimmung auf dem Evaluationsdatensatz. Alle Versionen wurden anhand derselben Kontrollpunkte und Beurteilenden entwickelt, daher sind die finalen Werte optimistisch. Ein zurückgehaltener Patient wäre der angemessene Test.
- Nicht unterscheidbar bedeutet nicht besser. Bei der verblindeten Bewertung waren das kleine Modell und die Frontier-Referenz bei dieser Stichprobengröße nicht voneinander zu unterscheiden; die Unterschiede liegen innerhalb des Eigenrauschens der beurteilenden Instanz.
- Gemeinsamer Klassifikator. Der Checklistenbewerter, der Satz-Scanner und der Verifier sind dasselbe Modell.
- Eine bescheidene Referenz. Die Frontier-Referenz ist ein einzelner früherer, nicht optimierter Pipeline-Durchlauf mit GPT-5.5, nicht eine mit demselben Zyklus abgestimmte Frontier-Pipeline.
Paper lesen, Zahlen prüfen
Das vollständige Paper steht kostenlos zum Download bereit. Das Datenpaket mit Checklisten, Bewertungen und Beispielbriefings wird per E-Mail verschickt.
Das Paper
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 Seiten, 9 Abbildungen.
Datenpaket herunterladen
PDF des Papers, alle neun Abbildungen, die drei Gold-Checklisten, Checklisten- und Verifier-Bewertungen für jede Version, verblindete Bewertungen aus den letzten Runden samt Zuordnung der Buchstaben sowie drei finale Beispielbriefings. Eine README erläutert alle Felder.
Wir geben keine E-Mail-Adressen weiter. Der Datenlink trifft innerhalb weniger Minuten ein.
Inhalt der ZIP-Datei
paper/: das Paper als PDFfigures/: neun Abbildungen und die zugrunde liegenden Zahlenscores/gold_checklists.json: 3 × 25 gewichtete Aussagenscores/checklist_results.json: Wahrscheinlichkeiten pro Element für 198 bewertete Briefingsscores/blind_review_R28.json,R29: sieben Kriterien, Urteile und Einwände samt Buchstabenzuordnungexample-briefs/: drei finale v28-Briefings (auf Polnisch, wie die Transkripte)
Nicht enthalten: synthetische Transkripte, Prompts und Code. Sie sind auf Anfrage für Forschungszwecke bei den Autor:innen erhältlich.
Zitierweise
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}