Mali model, pažljivo osmišljen cjevovod
Metoda autoresearcha za smanjenje razlike u odnosu na najsuvremenije LLM-ove pri sažimanju dugih dokumenata. Testirano na pripremnim sažecima za seansu izrađenima na temelju transkripata dvaju sintetičkih pacijenata.
Jeftin model može biti blizu ako radi manje
Najsuvremeniji jezični modeli dobro sažimaju duge dokumente, ali njihova primjena prije svakog rezultata postaje skupa. Mali su modeli jeftini, no gube informacije pri obradi dugih ulaza. Istražili smo koliko daleko može dogurati jeftin model kada je dio pažljivo osmišljenog cjevovoda i poboljšava se automatiziranim ciklusom koji svaku promjenu evaluira drugim modelima, bez ljudskih ocjenjivača.
Tijekom više od 30 verzija i 16 slijepih krugova pregleda rezultat malog modela porastao je s 0,647 na 0,846 na ponderiranom zlatnom popisu provjere (0,879 kada verifikator bez referentnog odgovora odabere najbolji od tri izvođenja). Referentni najsuvremeniji model ostvario je rezultat 0,782. U slijepom pregledu nadzornog LLM-a ta se dva modela nisu mogla razlikovati pri ovoj veličini uzorka: srednja uparena razlika iznosila je +0,05 (SD 0,49). Isti, nepromijenjeni referentni sažetak dobio je od tog nadzornog modela ocjene od 3,50 do 4,03 u 13 krugova, pa se pokazalo da je šum samog ocjenjivača važan nalaz.
Sadržaj
Dug ulaz, fiksna struktura, rutinska primjena
Mnogi praktični zadaci sažimanja dijele tri svojstva: ulaz je dug i raspoređen u mnogo dokumenata, izlaz slijedi fiksnu strukturu s brojčanim podacima, datumima i doslovnim dokazima, a budući da se izlaz izrađuje rutinski, trošak je važan.
Kao testni slučaj upotrijebili smo jedan takav zadatak: strukturirani sažetak koji kognitivno-bihevioralni terapeut može pročitati za otprilike tri minute prije seanse. U njemu se navode temeljna uvjerenja i broj seansi, pravila, ponavljajuća iskrivljenja, tipične ABC epizode, provjerena predviđanja, posljednja seansa te teme koje bi terapeut mogao otvoriti na današnjoj seansi. Do 20. seanse materijal obuhvaća oko 130 000 riječi.
Zadatak je prikladan za istraživanje metodologije jer ima poznatu strukturu (Beckov kognitivni model), prirodan oblik provjerljivih dokaza (doslovne riječi pacijenta) i nekoliko zamki: uvjerenje koje je prvi formulirao terapeut ili metaforu koja nije izjava o smrti.
Dva sintetička pacijenta
Oba pacijenta izrađena su našom slojevitom metodom generiranja sintetičkih pacijenata (najprije profil, terapijski tijek, plan seansi i vodič za glas, a zatim pojedinačno generirane seanse u obliku transkripata nalik ASR-u). Anita: 20 seansi, 131 498 riječi, KBT u stilu J. Becka. Markus: 12 seansi, 83 978 riječi; njegov terapeut djelomično se služi shematskom terapijom, pa sažetak mora prevesti sadržaj natrag u pojmove KBT-a. Za svakog je pacijenta neovisno izrađen zlatni referentni sažetak na temelju cjelovitog čitanja transkripata. Nisu korišteni podaci stvarnih pacijenata.
Podjela zadataka
Ključne promjene nisu se odnosile na bolje upute, nego na drukčiju raspodjelu odgovornosti. Svaka komponenta radi samo ono u čemu je dobra.
Deterministički kod
Sve što se može prebrojiti, poredati ili provjeriti
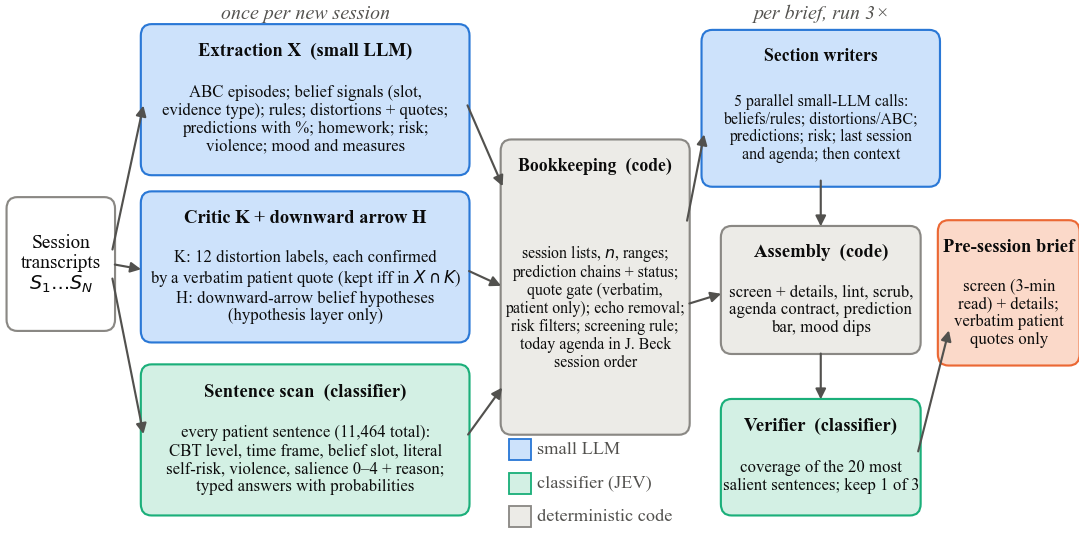
Popisi seansi, brojanja i rasponi za svako uvjerenje; lanci predviđanja povezani među seansama; filtar doslovnih citata koji odbacuje citate kojih nema u vlastitim iskazima pacijenta; uklanjanje terapeutovih odjeka te, od verzije 28, redoslijed predloženih tema za današnju seansu. Kad se pronađe programska pogreška u ovom kodu, ispravak ostaje.
Klasifikator rečenica
Prosudbe za koje nije potrebno generiranje teksta
Svaka rečenica pacijenta (ukupno 11 464) označava se jednom: razina KBT-a (automatska misao, pravilo, uvjerenje, emocija, ponašanje…), vremenski okvir (sada ili prisjećanje), doslovno ili preneseno značenje te moguća važnost rečenice za sljedeću seansu; za svaku se dodjeljuje i vjerojatnost. Isti klasifikator poslije služi kao verifikator bez referentnog odgovora i kao ocjenjivač popisa provjere.
Mali jezični model
Kratak tekst izrađen na temelju pripremljenog materijala
Za svaku seansu mali model izdvaja strukturu, potvrđuje iskrivljenja doslovnim citatima i predlaže hipoteze (koje se pohranjuju kao hipoteze, nikad kao dokazi). Za svaki sažetak pet pisaca odjeljaka radi usporedno; svaki vidi samo podatke označene brojem seanse za svoj odjeljak i dobiva uputu da nikad ne izmišlja brojeve seansi ni citate.
Najbolji od tri, bez uvida u odgovor
Razlike među izvođenjima unutar iste verzije često su bile veće od razlika među verzijama. Zato se cjevovod na razini sažetka pokreće tri puta, a verifikator odabire jedan: uzima 20 najuočljivijih rečenica pacijenta i traži od klasifikatora da procijeni je li svaka odražena u sažetku. Verifikatoru se ne prikazuju zlatni referentni sažetak ni popis provjere.
Autoresearch ciklus
Automatizirani razvojni ciklus nadahnut nedavnim radom na automatiziranom eksperimentiranju: predložiti jednu promjenu, isprobati je i zadržati samo ako se dvije neovisne metrike slažu.
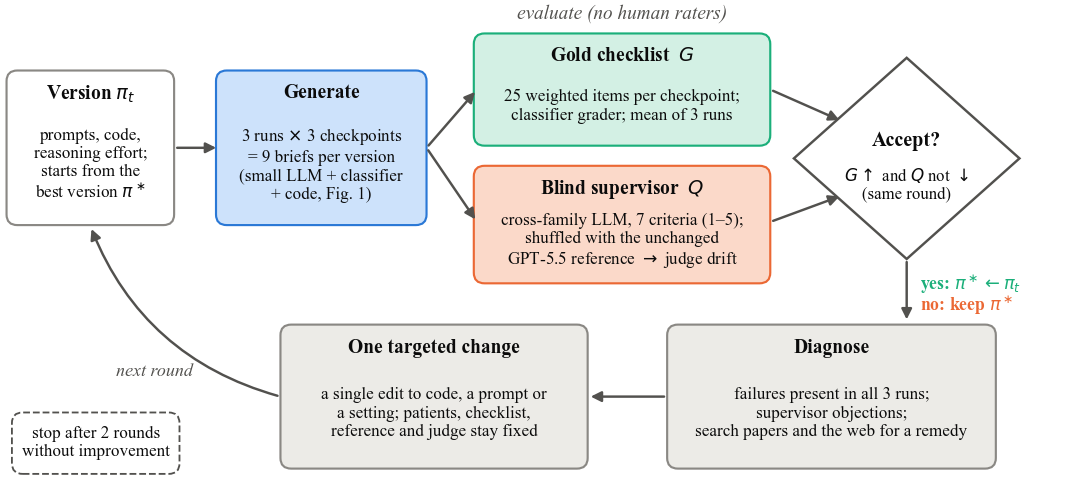
- Dvije metrike. Zlatni popis provjere s 25 ponderiranih tvrdnji po kontrolnoj točki, koji ocjenjuje klasifikator, te slijepi pregled nadzornog LLM-a iz druge obitelji modela, який ocjenjuje sedam kriteriја na ljestvici od 1 do 5.
- Fiksna referenca. Nadzornom modelu uvijek se prikazuje i jedan nepromijenjeni referentni sažetak najsuvremenijeg modela, označen nasumičnim slovom, kako bi se u svakom krugu mjerilo odstupanje samog ocjenjivača.
- Jedna promjena odjednom. Pogreške prisutne u sva tri izvođenja i primjedbe nadzornog modela potiču jednu ciljanu promjenu po krugu, uz uvid u pretraživanje literature.
- Fiksno pravilo zaustavljanja. Ciklus završava nakon dva uzastopna kruga bez poboljšanja. Zaustavio se na v28.
- Fiksna gornja granica troška. Unutar cjevovoda ne smije se koristiti model skuplji od malog modela ili klasifikatora.
Što smo opazili
Deskriptivna statistika za tri kontrolne točke (Anita prije 13. i 20. seanse, Markus prije 12. seanse) i tri izvođenja po verziji.
Pokrivenost sadržaja: zlatni popis provjere
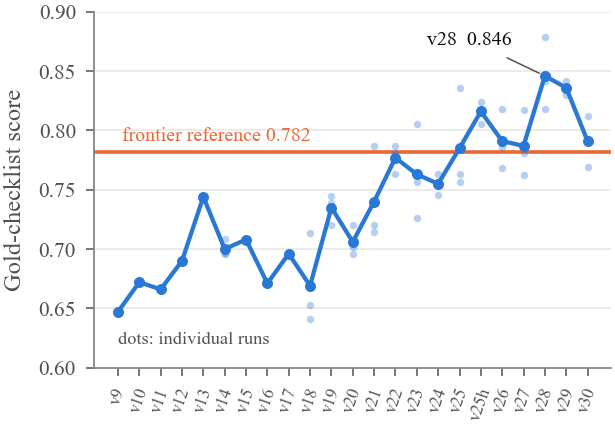
Mali model započeo je znatno ispod referentne vrijednosti (0,647 prema 0,782), premašio ju je na v25 i dosegnuo 0,846 na v28. Sva tri izvođenja v28 (0,818, 0,842, 0,879) premašila su referentnu vrijednost. Dvije kasnije verzije nisu nadmašile v28 pa je ciklus zaustavljen.
| Anita, prije S13 | Anita, prije S20 | Markus, prije S12 | |
|---|---|---|---|
| v28, prosjek 3 izvođenja | 0,963 | 0,800 | 0,776 |
| v28, najbolji od 3 (verifikator) | 0,963 | 0,836 | 0,836 |
| referentni GPT-5.5 (1 izvođenje) | 0,963 | 0,655 | 0,727 |
Prosjeci po kontrolnim točkama: v28 0,846 · najbolji od 3 0,879 · referentna vrijednost 0,782.
Slijepi pregled: unutar šuma ocjenjivača
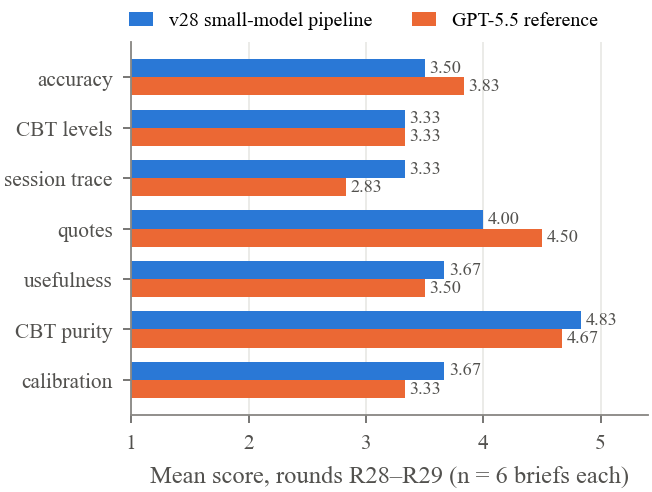
U završnim krugovima najbolja verzija malog modela i referentni model dobili su ocjene 3,77 prema 3,87 (R28) te 3,77 prema 3,57 (R29). U šest parova iz istih krugova razlike su bile −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: prosjek +0,05, SD 0,49. Nijedan sustav nije dosegnuo ciljanu prosječnu ocjenu nadzornog modela od 4,0. Po kriterijima je v28 bio bolji u praćenju seansi i kalibraciji, slabiji u točnosti (slaganju sa zlatnim referentnim sažetkom) i citatima te izjednačen u razinama KBT-a.
Trošak
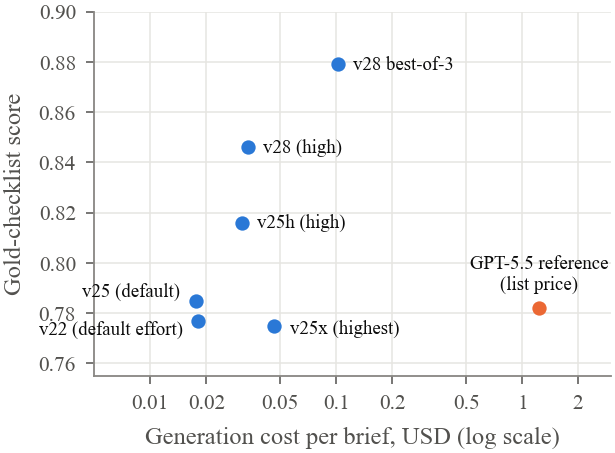
Izrada jednog sažetka v28 stoji oko USD 0,03 za pisanje odjeljaka i traje 2,5–3 minute; sažetak odabran postupkom najboljeg od 3 stoji oko USD 0,11. Obrada nove seanse dodaje oko USD 0,07, uglavnom zbog prolaza klasifikatora kroz svaku rečenicu. Prema kataloškim cijenama referentni sažetak najsuvremenijeg modela stoji oko 19 puta više od pojedinačnog sažetka v28. Cijeli je projekt potrošio USD 5,57 na tokene malog modela.
Što je pomoglo, a što nije
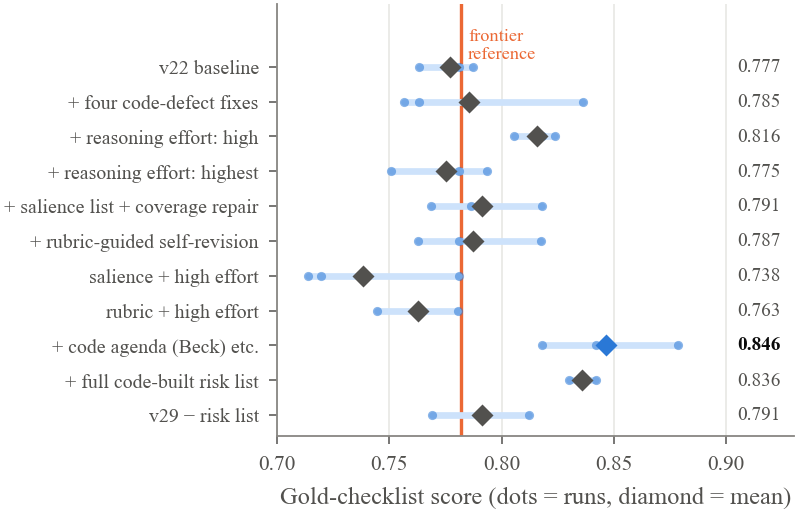
Pomogle su tri stvari: ispravljanje nedostataka u determinističkom kodu koje je pronašao nadzorni model, visoka razina napora za zaključivanje za pisce odjeljaka (najviša razina bila je skuplja i donijela niži rezultat) te premještanje predloženog dnevnog reda, trake predviđanja i najnovije izjave povezane s rizikom u kod. Nekoliko prividno razboritih dodataka pogoršalo je rezultat: spajanje triju nacrta, vremenska crta uvjerenja nametnuta kodom, naznake važnosti uz naknadni popravak pokrivenosti te samostalna dorada prema rubrici. Svaki je od njih dodao korak generiranja u kojem mali model može izgubiti ili iskriviti informacije. Sve promjene koje su modelu oduzele dio posla ili odabrale među izlazima bez njihova prepisivanja pokazale su se sigurnima.
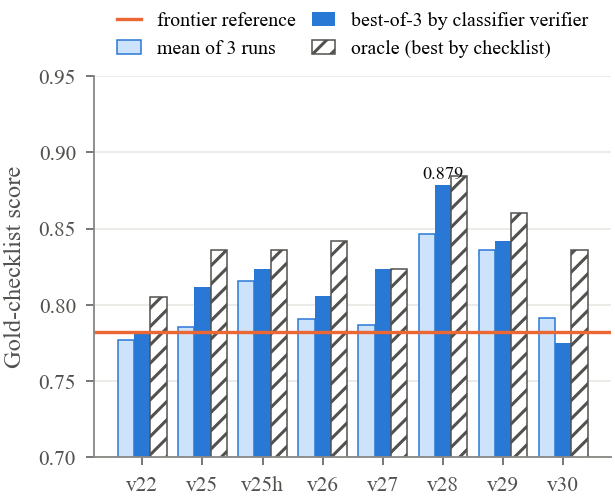
Odabir verifikatorom poboljšao je rezultat na popisu provjere u sedam od osam verzija; za v28 s 0,846 na 0,879, blizu orakulskog rezultata (0,885). Budući da su verifikator i ocjenjivač popisa provjere isti klasifikator, dio tog poboljšanja može odražavati zajedničke preferencije.
Što je ostalo teško
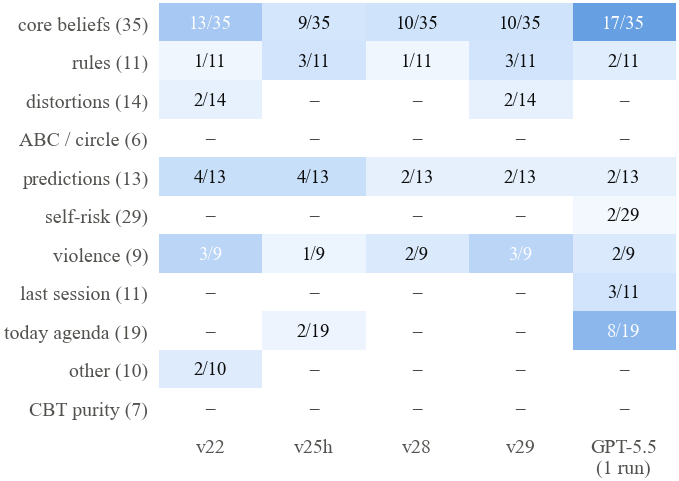
Broj trajnih pogrešaka pao je s 25 na 15 od ukupno 164 ponderirane jedinice između v22 i v28. Preostaju najistančanije prosudbe kognitivnog modela: stanje uvjerenja nakon njegove ponovne aktivacije, rasponi uvjerenja koji ne obuhvaćaju najnoviji materijal te ograničenja opsega. Iskazi o riziku bili su najteži dio: kažnjavalo se i izostavljanje novije izjave i pretvaranje metafore, vježbe ili ocjene emocije u signal. Najbolje je rješenje zadržalo samo najnoviju doslovnu izjavu i seansu u kojoj je terapeut posljednji put izravno pitao o njoj, a sva tumačenja prepustilo terapeutu.
Ocjenjivač je dio eksperimenta
Budući da se referentni sažetak nije mijenjao, njegove ocjene mjere samo rad nadzornog modela.
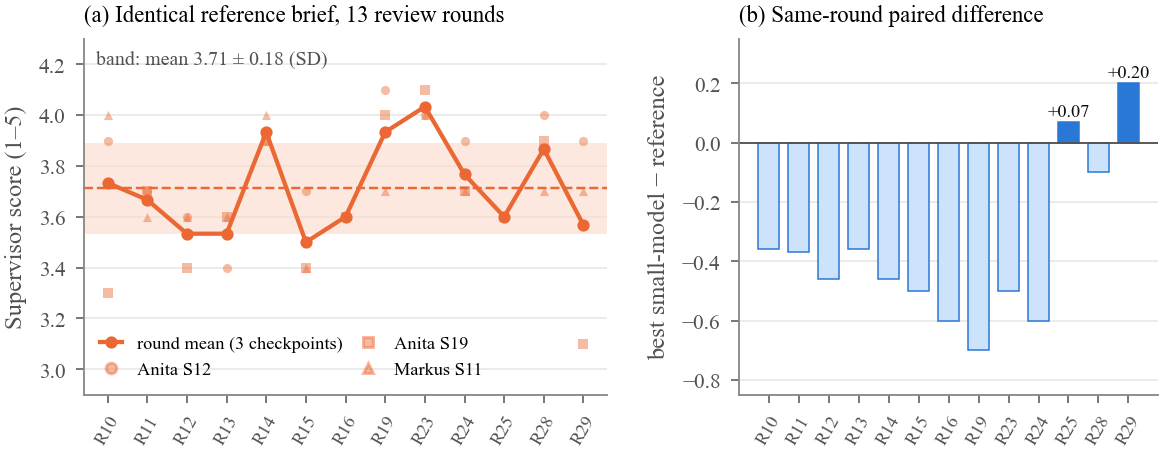
Tijekom 13 krugova isti je referentni sažetak dobio prosječnu ocjenu kruga 3,71 uz SD 0,18 i raspon 3,50–4,03 na ljestvici od 1 do 5. Za pojedinačne kriterije SD je dosegnuo 0,46, čak i za citate koji su provjereni skriptom i svaki put bili isti. Taj je šum približno jednak ukupnom poboljšanju koje je ciklus donio na istoj ljestvici.
Što ova studija ne pokazuje
- Samo sintetički podaci. Dva sintetička pacijenta, tri kontrolne točke, tri izvođenja po verziji. Samo deskriptivna statistika, bez testova statističke značajnosti. Mogućnost prijenosa na druge zadatke i stvarni materijal obrazlaže se, ali nije prikazana.
- Samo evaluacija pomoću modela. Namjerno nisu sudjelovali kliničari ni drugi ljudski ocjenjivači. Rezultati opisuju slaganje sa zlatnim popisom provjere i prosudbom nadzornog LLM-a, a ne kliničku kvalitetu, sigurnost ni ikakav učinak na terapiju.
- Prilagodba evaluacijskom skupu. Sve su verzije razvijene na istim kontrolnim točkama i uz iste ocjenjivače, pa su završni rezultati optimistični. Ispravan bi test bio na pacijentu koji nije korišten tijekom razvoja.
- Nemogućnost razlikovanja ne znači da je nešto bolje. U slijepom pregledu mali model i referentni najsuvremeniji model nisu se mogli razlikovati pri ovoj veličini uzorka; razlike su unutar samog šuma ocjenjivača.
- Zajednički klasifikator. Ocjenjivač popisa provjere, analizator rečenica i verifikator isti su model.
- Skroman referentni model. Referentni najsuvremeniji model jedno je ranije, neoptimizirano pokretanje cjevovoda s modelom GPT-5.5, a ne cjevovod najsuvremenijeg modela optimiziran istim ciklusom.
Pročitajte rad, provjerite brojke
Cijeli je rad besplatno dostupan za preuzimanje. Paket podataka s popisima provjere, rezultatima i primjerima sažetaka šaljemo e-poštom.
Rad
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 stranica, 9 slika.
Preuzmite paket podataka
PDF rada, svih devet slika, tri zlatna popisa provjere, rezultati popisa provjere i verifikatora za svaku verziju, slijepi pregledi iz završnih krugova s ključevima slova te tri završna primjera sažetaka. Datoteka README objašnjava svako polje.
Ne dijelimo adrese. Poveznica na podatke stiže za nekoliko minuta.
Sadržaj ZIP arhive
paper/: rad u PDF-ufigures/: devet slika i brojčani podaci na kojima se temeljescores/gold_checklists.json: 3 × 25 ponderiranih tvrdnjiscores/checklist_results.json: vjerojatnosti po stavkama za 198 ocijenjenih sažetakascores/blind_review_R28.json,R29: sedam kriterija, presude i primjedbe, s ključevima slovaexample-briefs/: tri završna sažetka v28 (na poljskom, kao i transkripti)
Nisu uključeni: sintetički transkripti, upute i kod. Autori ih mogu ustupiti na zahtjev za potrebe istraživanja.
Kako citirati
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}