Небольшая модель, тщательно спроектированный конвейер
Метод автоисследований для сокращения разрыва с передовыми LLM при суммаризации длинных материалов из нескольких документов. Проверен на сводках перед сессиями, составленных по стенограммам двух синтетических пациентов.
Недорогая модель может приблизиться к передовой, если поручить ей меньше
Передовые языковые модели хорошо суммируют длинные материалы из нескольких документов, но использовать такую модель перед каждой выдачей дорого. Небольшие модели дешевы, но теряют информацию при обработке длинных входных данных. Мы выяснили, насколько далеко может продвинуться недорогая модель, если встроить её в тщательно спроектированный конвейер и совершенствовать с помощью автоматизированного цикла, в котором каждое изменение оценивается другими моделями без участия людей-оценщиков.
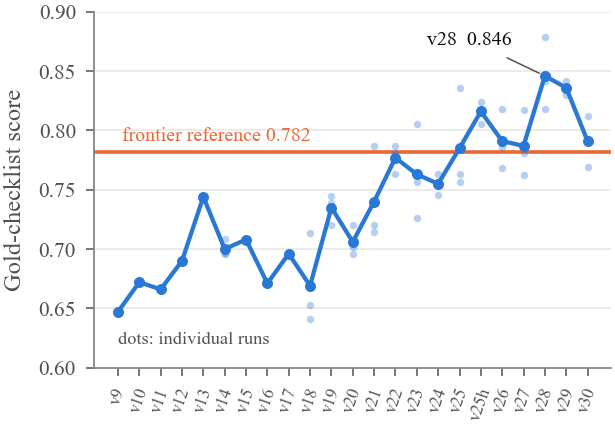
За более чем 30 версий и 16 раундов слепой оценки результат небольшой модели по взвешенному эталонному чек-листу вырос с 0,647 до 0,846 (0,879, если из трёх запусков выбирает верификатор, не имеющий доступа к эталону). Эталон передового уровня набрал 0,782. При слепой оценке LLM-супервизором эти две модели оказались неразличимы при данном размере выборки: средняя парная разница составила +0,05 (SD 0,49). Одна и та же, неизменённая эталонная сводка получила от этого супервизора оценки от 3,50 до 4,03 за 13 раундов, поэтому собственный шум судьи оказался отдельным результатом исследования.
Содержание
Длинный вход, фиксированная структура, регулярное применение
Многие практические задачи суммаризации обладают тремя общими свойствами: входные данные длинные и распределены по множеству документов; результат имеет фиксированную структуру с подсчётами, датами и дословными свидетельствами; результат нужен регулярно, поэтому важна стоимость.
В качестве испытательного примера мы взяли одну такую задачу: структурированную сводку, которую когнитивно-поведенческий терапевт может прочитать примерно за три минуты до сессии. В ней перечислены базовые убеждения с количеством сессий, правила, повторяющиеся когнитивные искажения, типичные эпизоды ABC, проверенные прогнозы, содержание последней сессии и пункты, которые терапевт может захотеть обсудить сегодня. К 20-й сессии объём материала достигает примерно 130 000 слов.
Эта задача подходит для исследования методов, поскольку у неё есть известная структура (когнитивная модель Бека), естественный тип проверяемых свидетельств (дословные слова пациента) и несколько подводных камней: убеждение, которое сначала сформулировал терапевт, или метафора, не являющаяся высказыванием о смерти.
Два синтетических пациента
Оба пациента были созданы с помощью нашего многоэтапного метода генерации синтетических пациентов (сначала профиль, терапевтическая траектория, план сессий и руководство по голосу, затем сессии генерировались по одной в виде стенограмм в стиле ASR). Anita: 20 сессий, 131 498 слов, КПТ в стиле Дж. Бека. Markus: 12 сессий, 83 978 слов; терапевт частично использует схематерапию, поэтому в сводке материал нужно перевести обратно в термины КПТ. Для каждого пациента эталонную сводку независимо составили на основе полного прочтения стенограмм. Данные реальных пациентов не использовались.
Распределение задач
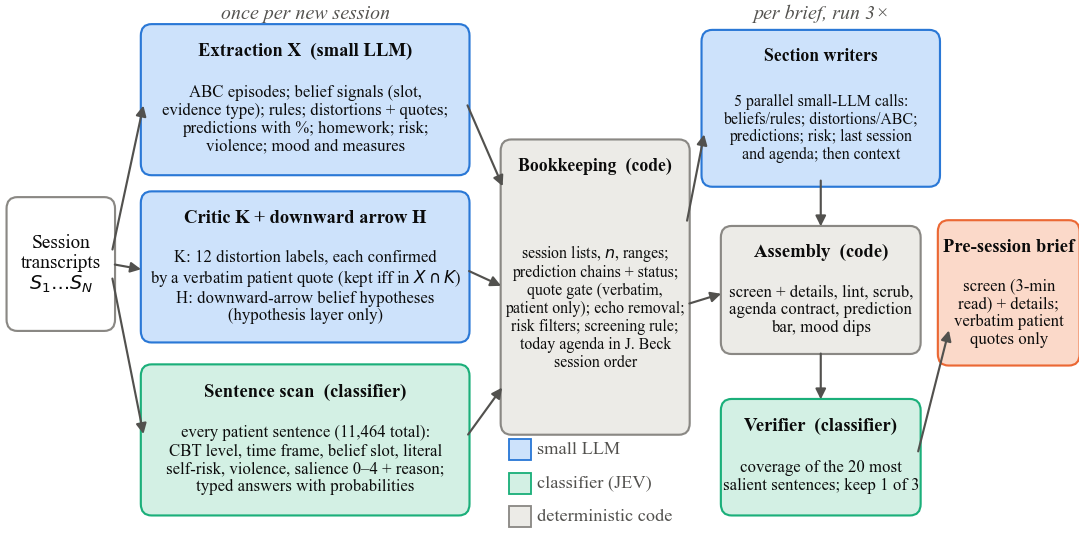
Решающими оказались не улучшенные промпты, а новое распределение обязанностей. Каждый компонент выполняет только то, что ему хорошо удаётся.
Детерминированный код
Всё, что можно подсчитать, упорядочить или проверить
Списки сессий, подсчёты и диапазоны для каждого убеждения; цепочки прогнозов, связанные между сессиями; фильтр дословных цитат, удаляющий цитаты, которых нет в собственных репликах пациента; удаление повторов слов терапевта; а начиная с версии 28 — порядок предлагаемых тем для сегодняшней сессии. После обнаружения дефекта этот код исправляется окончательно.
Классификатор предложений
Оценки, для которых не нужна генерация текста
Каждое предложение пациента (всего 11 464) однократно получает метки: уровень КПТ (автоматическая мысль, правило, убеждение, эмоция, поведение…), временная рамка (настоящее или воспоминание), буквальное или переносное значение, а также возможная значимость для следующей сессии; для каждой метки указывается вероятность. Позже тот же классификатор используется как верификатор без доступа к эталону и как оценщик чек-листа.
Небольшая языковая модель
Краткий текст на основе подготовленного материала
Для каждой сессии небольшая модель извлекает структуру, подтверждает когнитивные искажения дословными цитатами и предлагает гипотезы (они сохраняются именно как гипотезы, а не как свидетельства). Для каждой сводки пять авторов разделов работают параллельно; каждый видит только данные с номерами сессий для своего раздела и получает указание никогда не придумывать номера сессий или цитаты.
Лучший из трёх — без доступа к ответу
Различия между запусками одной версии часто были больше, чем различия между версиями. Поэтому конвейер на уровне сводки запускается трижды, а затем верификатор выбирает один вариант: он берёт 20 наиболее значимых предложений пациента и просит классификатор определить, отражено ли каждое из них в сводке. Верификатор не видит эталон или чек-лист.
Цикл автоисследований
Автоматизированный цикл разработки в духе недавних работ по автоматизации экспериментов: предложить одно изменение, проверить его и оставить, только если согласуются две независимые метрики.
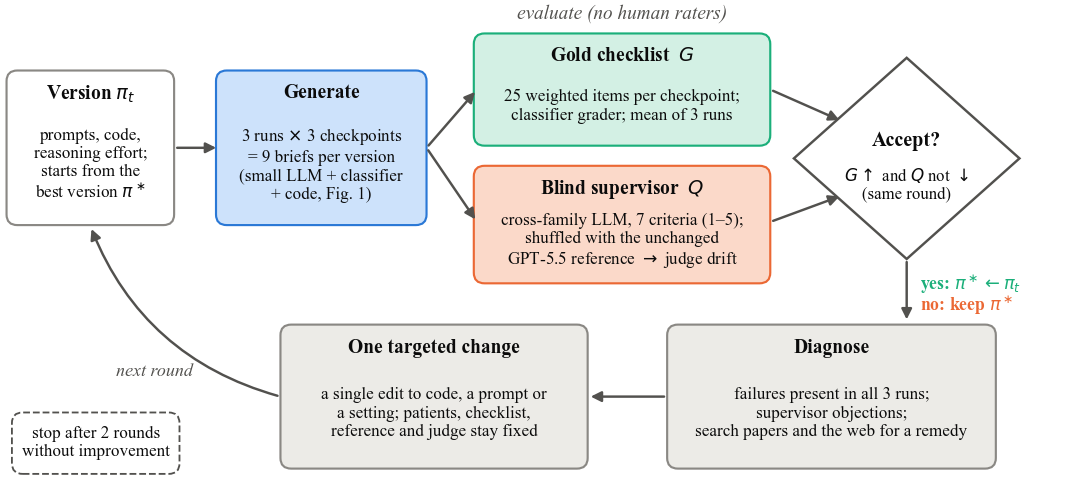
- Две метрики. Эталонный чек-лист из 25 взвешенных утверждений для каждой контрольной точки, который оценивает классификатор, и слепая оценка LLM-супервизора из другого семейства моделей по семи критериям по шкале от 1 до 5.
- Фиксированный ориентир. Супервизору всегда также показывают один неизменённый эталонный вариант передового уровня под случайной буквой, чтобы в каждом раунде измерять дрейф самого судьи.
- Одно изменение за раз. Ошибки, присутствующие во всех трёх запусках, и замечания супервизора приводят к одному целевому изменению за раунд с учётом поиска литературы.
- Фиксированное правило остановки. Цикл прекращается после двух раундов подряд без улучшения. Он остановился на v28.
- Фиксированный предел стоимости. Внутри конвейера нельзя использовать модели дороже небольшой модели или классификатора.
Что мы наблюдали
Описательная статистика по трём контрольным точкам (Anita перед 13-й и 20-й сессиями, Markus перед 12-й) и трём запускам каждой версии.
Охват содержания: эталонный чек-лист
Небольшая модель начала заметно уступать эталону (0,647 против 0,782), превзошла его на v25 и достигла 0,846 на v28. Все три запуска v28 (0,818, 0,842, 0,879) выше эталонного результата. Две последующие версии не превзошли v28, и цикл остановился.
| Anita, перед S13 | Anita, перед S20 | Markus, перед S12 | |
|---|---|---|---|
| v28, среднее по 3 запускам | 0,963 | 0,800 | 0,776 |
| v28, лучший из 3 (верификатор) | 0,963 | 0,836 | 0,836 |
| Эталон GPT-5.5 (1 запуск) | 0,963 | 0,655 | 0,727 |
Средние по контрольным точкам: v28 — 0,846 · лучший из 3 — 0,879 · эталон — 0,782.
Слепая оценка: в пределах шума судьи
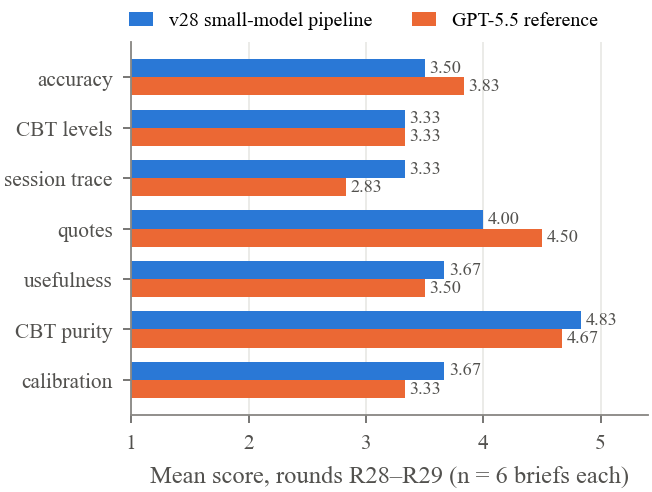
В финальных раундах лучшая версия небольшой модели и эталон получили 3,77 против 3,87 (R28) и 3,77 против 3,57 (R29). Для шести пар в одном раунде разница составила −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: среднее +0,05, SD 0,49. Ни одна из систем не достигла целевого среднего супервизора 4,0. По отдельным критериям v28 опережала по отслеживанию сессий и калибровке, уступала по точности (соответствию эталону) и цитатам, а по уровням КПТ шла наравне.
Стоимость
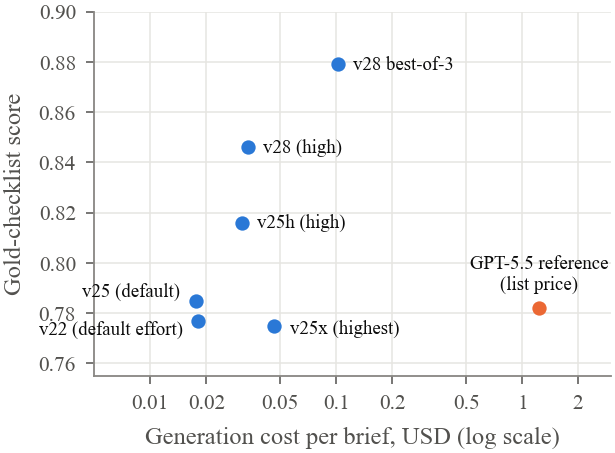
Создание одной сводки v28 стоит около 0,03 USD за написание разделов и занимает 2,5–3 минуты; сводка с выбором лучшего из трёх — около 0,11 USD. Обработка новой сессии добавляет примерно 0,07 USD, в основном за проход классификатора по каждому предложению. По прейскурантным ценам создание эталонной сводки передового уровня обходится примерно в 19 раз дороже одной сводки v28. На весь проект было потрачено 5,57 USD на токены небольшой модели.
Что помогло, а что нет
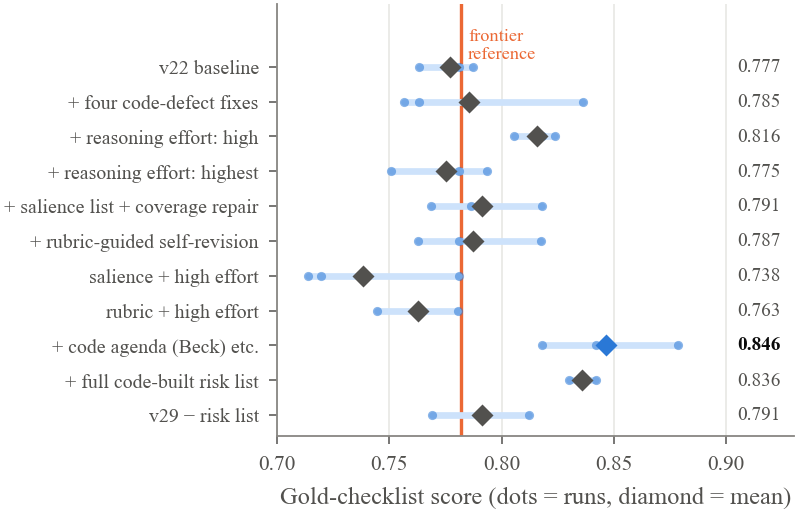
Помогли три вещи: исправление дефектов детерминированного кода, обнаруженных супервизором; высокий уровень усилий на рассуждение для авторов разделов (максимальный уровень стоил дороже и давал более низкие оценки); перенос предлагаемой повестки, шкалы прогнозов и самого недавнего высказывания, связанного с риском, в код. Несколько правдоподобных улучшений ухудшили результат: объединение трёх черновиков, заданная кодом временная шкала убеждений, подсказки о значимости с последующим исправлением пробелов в охвате и саморедактирование по рубрике. Каждое из них добавляло этап генерации, на котором небольшая модель могла потерять или исказить информацию. Все изменения, сокращавшие объём работы модели или позволявшие выбирать между результатами без их переписывания, были безопасными.
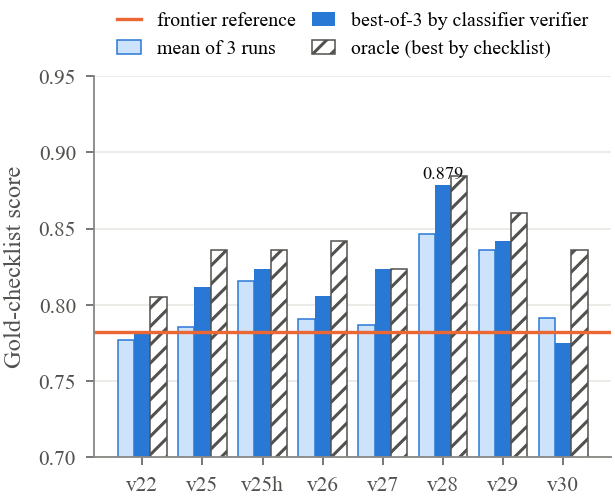
Выбор верификатором повысил оценку по чек-листу для семи из восьми версий; для v28 — с 0,846 до 0,879, близко к результату оракула (0,885). Поскольку верификатор и оценщик чек-листа — один и тот же классификатор, часть этого прироста может отражать совпадение предпочтений.
Что оставалось трудным
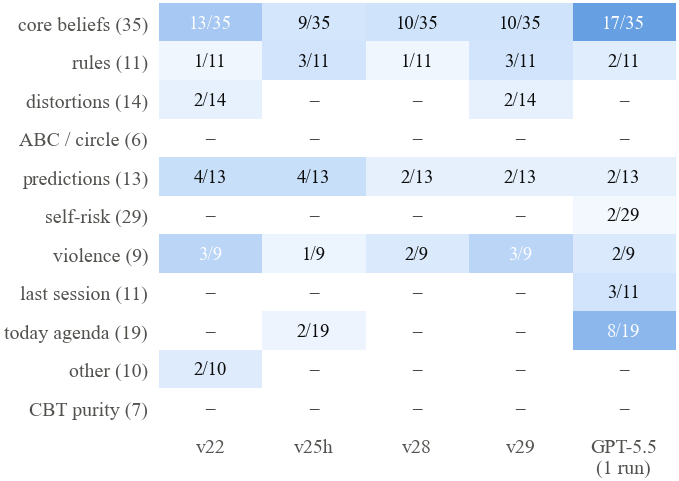
Количество сохранявшихся ошибок снизилось с 25 до 15 из 164 весовых единиц между v22 и v28. Оставшиеся ошибки связаны с наиболее тонкими суждениями когнитивной модели: состоянием убеждения после его повторной активации, диапазонами убеждений, которые не охватывают самый свежий материал, и уточнениями области действия. Сложнее всего оказались высказывания о риске: штрафовались как пропуск недавнего высказывания, так и превращение метафоры, упражнения или оценки эмоции в сигнал. Наилучший вариант сохранял только самое недавнее буквальное высказывание и сессию, на которой терапевт в последний раз прямо задавал этот вопрос, оставляя все интерпретации терапевту.
Судья — часть эксперимента
Поскольку эталонная сводка не менялась, её оценки отражают только работу супервизора.
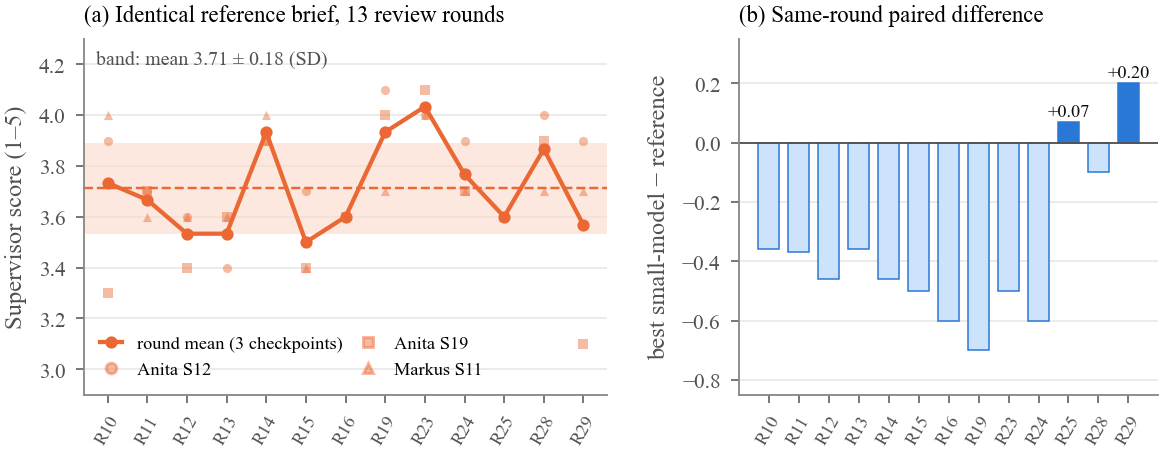
За 13 раундов идентичная эталонная сводка получила среднюю оценку 3,71 при SD 0,18 и диапазоне 3,50–4,03 по шкале от 1 до 5. Для отдельных критериев SD достигало 0,46, в том числе для цитат, проверенных скриптом и неизменных в каждом запуске. Этот шум по масштабу сопоставим со всем улучшением, достигнутым циклом по той же шкале.
Чего это исследование не показывает
- Только синтетические данные. Два синтетических пациента, три контрольные точки, три запуска каждой версии. Только описательная статистика, без проверки статистической значимости. Перенос на другие задачи и реальные материалы обосновывается, но не демонстрируется.
- Оценка только с помощью моделей. По замыслу в исследовании не участвовали клиницисты или другие люди-оценщики. Оценки описывают соответствие эталонному чек-листу и суждения LLM-супервизора, а не клиническое качество, безопасность или какое-либо влияние на терапию.
- Настройка на наборе для оценки. Все версии разрабатывались на одних и тех же контрольных точках и с теми же судьями, поэтому итоговые оценки оптимистичны. Надлежащей проверкой был бы пациент из отложенной выборки.
- Неразличимость не означает превосходства. При слепой оценке небольшую модель и эталон передового уровня не удалось различить при данном размере выборки; разница находится в пределах собственного шума судьи.
- Общий классификатор. Оценщик чек-листа, сканер предложений и верификатор — одна и та же модель.
- Умеренный эталон. Эталон передового уровня — это один запуск более раннего, неоптимизированного конвейера с GPT-5.5, а не передовой конвейер, настроенный тем же циклом.
Читайте статью, проверяйте цифры
Полную статью можно скачать бесплатно. Пакет данных с чек-листами, оценками и примерами сводок отправляется по электронной почте.
Статья
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Препринт, 13 страниц, 9 рисунков.
Скачать пакет данных
PDF статьи, все девять рисунков, три эталонных чек-листа, оценки по чек-листу и верификатору для каждой версии, слепые оценки финальных раундов с ключами букв и три итоговых примера сводок. В README описано каждое поле.
Мы не передаём адреса третьим лицам. Ссылка на данные придёт в течение нескольких минут.
Что входит в ZIP
paper/: статья в формате PDFfigures/: девять рисунков и исходные числовые данныеscores/gold_checklists.json: 3 × 25 взвешенных утвержденийscores/checklist_results.json: вероятности по отдельным пунктам для 198 оценённых сводокscores/blind_review_R28.json,R29: семь критериев, выводы и замечания с ключами буквexample-briefs/: три итоговые сводки v28 (на польском, как и стенограммы)
Не включены: синтетические стенограммы, промпты и код. Их можно запросить у авторов для исследовательского использования.
Как цитировать
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}