Kis modell, gondosan megtervezett pipeline
Autoresearch-módszer a frontier LLM-ekkel szembeni különbség csökkentésére hosszú, több dokumentumot felölelő összefoglalásban. Két szintetikus páciens átirataiból készített, ülés előtti összefoglalókon tesztelve.
Egy olcsó modell is közel kerülhet, ha kevesebbet kell tennie
A frontier nyelvi modellek jól összefoglalják a hosszú, több dokumentumból álló anyagokat, de költséges minden kimenet előtt futtatni őket. A kis modellek olcsók, viszont hosszú bemeneteken információt veszítenek. Azt vizsgáltuk, milyen messzire juthat egy alacsony költségű modell egy gondosan megtervezett pipeline részeként, ha egy automatizált ciklus javítja, amely minden változtatást más modellekkel értékel, emberi értékelők nélkül.
Több mint 30 verzió és 16 vak értékelési kör során a kis modell pontszáma 0,647-ről 0,846-ra emelkedett a súlyozott gold checklisten (0,879, ha egy referencia nélküli verifier választja ki a három futás legjobbját). A frontier referencia pontszáma 0,782 volt. Egy LLM-felügyelő vak értékelése során ekkora mintánál nem lehetett megkülönböztetni a kettőt: a párosított különbség átlaga +0,05 (SD 0,49) volt. Ugyanez a változatlan referencia-összefoglaló 13 kör során 3,50 és 4,03 közötti pontszámot kapott ettől a felügyelőtől, így a bíráló saját zajossága önmagában is eredménynek bizonyult.
Tartalom
Hosszú bemenet, rögzített struktúra, rendszeres használat
Számos gyakorlati összefoglalási feladat három jellemzővel bír: a bemenet hosszú és sok dokumentumban oszlik el; a kimenet rögzített szerkezetet követ, számlálásokkal, dátumokkal és szó szerinti bizonyítékokkal; a kimenet pedig rendszeresen készül, ezért számít a költség.
Próbafeladatként egy ilyen feladatot használtunk: egy strukturált összefoglalót, amelyet egy CBT-terapeuta körülbelül három perc alatt el tud olvasni az ülés előtt. Felsorolja az alapvető hiedelmeket az ülések számával, a szabályokat, a visszatérő torzításokat, a jellemző ABC-epizódokat, a tesztelt előrejelzéseket, az utolsó ülést, valamint azokat a pontokat, amelyeket a terapeuta esetleg fel szeretne vetni a mai ülésen. A 20. ülésre az anyag körülbelül 130 000 szavas.
A feladat módszertani szempontból azért megfelelő, mert ismert struktúrája van (Beck kognitív modellje), természetes módon ellenőrizhető bizonyítékra támaszkodik (a páciens szó szerinti mondataira), és több lehetséges buktatót is tartalmaz: például egy hiedelmet, amelyet először a terapeuta fogalmazott meg, vagy egy metaforát, amely nem a halálról szóló kijelentés.
Két szintetikus páciens
Mindkét pácienst rétegzett szintetikus-páciens módszerünkkel hoztuk létre (először profiladatlap, terápiás ív, ülésenkénti terv és hangnem-útmutató készült, majd az üléseket egyenként generáltuk, ASR-jellegű átiratok formájában). Anita: 20 ülés, 131 498 szó, J. Beck-féle CBT. Markus: 12 ülés, 83 978 szó; terapeutája részben sématerápiás megközelítést alkalmaz, ezért az összefoglalónak CBT-s fogalmakra kell átültetnie az anyagot. Mindkét páciens esetében külön, az átiratok teljes elolvasása alapján készült az arany standardként szolgáló referencia. Valós páciensek adatait nem használtuk.
Munkamegosztás
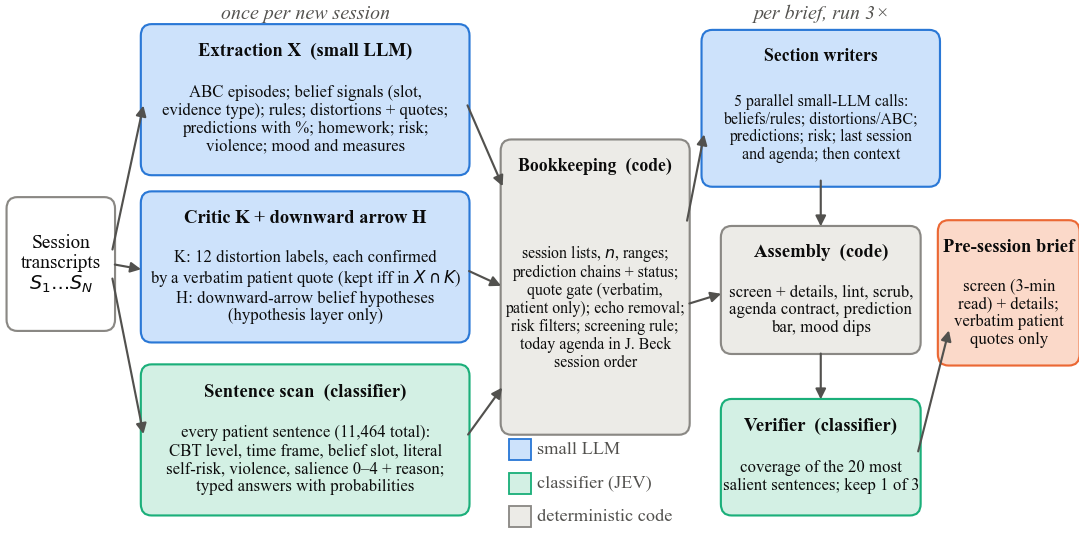
A döntő változtatások nem a jobb promptok, hanem a feladatkörök átrendezése voltak. Mindegyik komponens csak azt végzi, amiben jó.
Determinista kód
Minden, ami megszámolható, sorba rendezhető vagy ellenőrizhető
Az egyes hiedelmek üléseinek listái, számai és tartományai; az üléseken átívelően összekapcsolt előrejelzési láncok; egy szó szerinti idézeteket ellenőrző szűrő, amely elvet minden, a páciens saját mondatai között nem szereplő idézetet; a terapeuta visszhangjainak eltávolítása; valamint a 28-as verziótól a mai ülésre javasolt pontok sorrendje is. Ha egyszer hibát találunk ebben a kódban, azt kijavítjuk, és úgy is marad.
Mondatosztályozó
Olyan értékelések, amelyekhez nincs szükség szöveggenerálásra
A rendszer minden páciensmondatot (összesen 11 464-et) egyszer címkéz: CBT-szint (automatikus gondolat, szabály, hiedelem, érzelem, viselkedés stb.), időkeret (jelen vagy felidézett), szó szerinti vagy képletes megfogalmazás, valamint az, hogy a mondat mennyire lehet fontos a következő ülés szempontjából; mindegyikhez valószínűséget rendel. Ugyanez a klasszifikátor később referencia nélküli verifierként és az ellenőrzőlista pontozójaként is szolgál.
Kis nyelvi modell
Rövid szövegek írása előkészített anyagból
Ülésenként a kis modell struktúrát nyer ki, szó szerinti idézetekkel erősíti meg a torzításokat, és hipotéziseket fogalmaz meg (ezek hipotézisként tárolódnak, soha nem bizonyítékként). Az összefoglalóhoz öt szakaszíró fut párhuzamosan; mindegyik csak a saját szakaszához tartozó, ülésszámmal ellátott adatokat látja, és utasítást kap arra, hogy ne találjon ki ülésszámokat vagy idézeteket.
A három közül a legjobb, a válasz megtekintése nélkül
Egy verzión belül a futások közötti különbségek gyakran nagyobbak voltak, mint a verziók közötti különbségek. Ezért az összefoglalókat készítő pipeline háromszor fut le, majd egy verifier választ közülük: kiválasztja a páciens 20 legfontosabb mondatát, és megkéri a klasszifikátort, hogy ellenőrizze, mindegyik tükröződik-e az összefoglalóban. A verifier nem látja az arany standardként szolgáló referenciát vagy az ellenőrzőlistát.
Az autoresearch-ciklus
Automatizált fejlesztési ciklus a közelmúlt automatizált kísérletezési munkáinak szellemében: egy változtatás javaslata és kipróbálása, majd csak akkor megtartása, ha két független mérőszám egyetért.
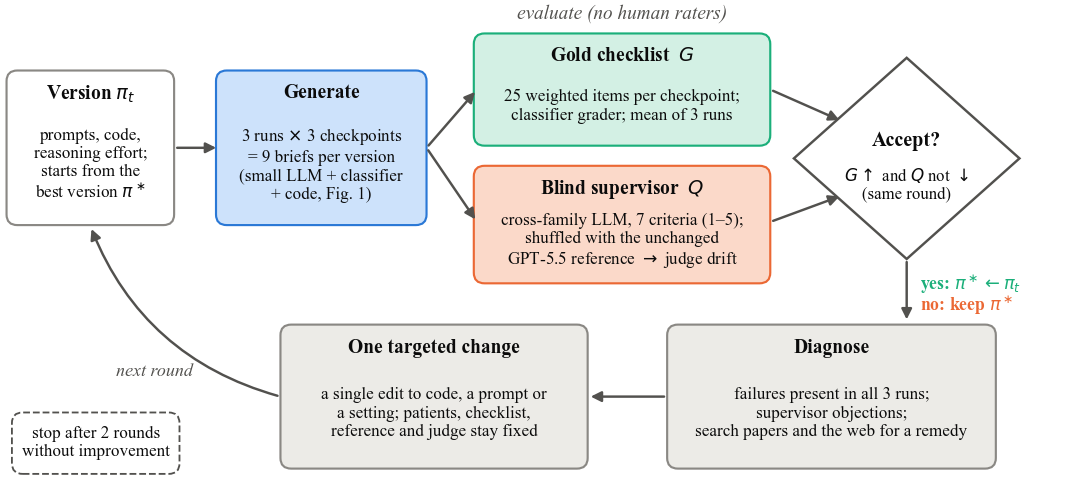
- Két mérőszám. Ellenőrzőpontonként 25 súlyozott állításból álló gold checklist, amelyet a klasszifikátor pontoz, valamint vak értékelés egy másik modellcsaládba tartozó LLM-felügyelőtől, aki hét szempontot értékel 1–5-ös skálán.
- Rögzített viszonyítási alap. A felügyelő mindig lát egy változatlan frontier referencia-összefoglalót is, véletlenszerű betűjellel, így minden körben mérhető a bíráló saját elmozdulása.
- Egyszerre egy változtatás. Az mindhárom futásban jelentkező hibák és a felügyelő észrevételei alapján, szakirodalmi kereséssel kiegészítve, körönként egy célzott változtatást végzünk.
- Rögzített leállási szabály. Két egymást követő javulás nélküli kör lezárja a ciklust. A folyamat a v28-nál állt le.
- Rögzített költségplafon. A pipeline-on belül nem használható a kis modellnél vagy a klasszifikátornál drágább modell.
Amit megfigyeltünk
Leíró statisztikák három ellenőrzőponton (Anita esetében a 13. és 20. ülés előtt, Markus esetében a 12. ülés előtt), verziónként három futással.
Tartalmi lefedettség: a gold checklist
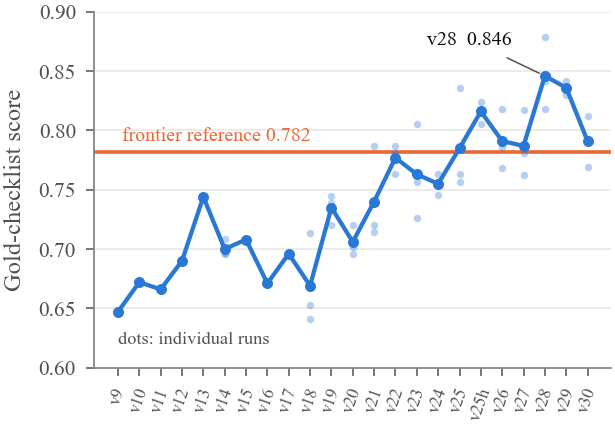
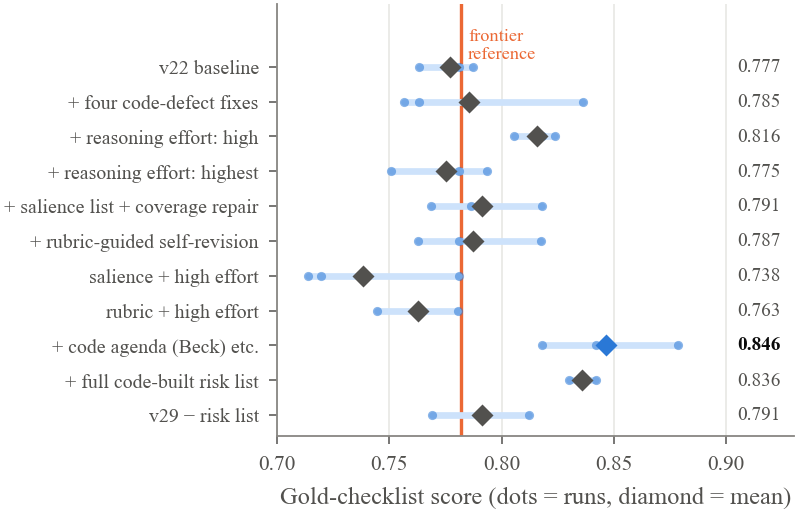
A kis modell jóval a referencia alatt kezdett (0,647, szemben a 0,782-vel), a v25-nél elérte, majd meghaladta azt, a v28-nál pedig 0,846-ot ért el. Mindhárom v28-as futás (0,818; 0,842; 0,879) a referencia fölött van. Két későbbi verzió nem javított a v28 eredményén, ezért a ciklus leállt.
| Anita, az S13 előtt | Anita, az S20 előtt | Markus, az S12 előtt | |
|---|---|---|---|
| v28, 3 futás átlaga | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifier) | 0,963 | 0,836 | 0,836 |
| GPT-5.5 referencia (1 futás) | 0,963 | 0,655 | 0,727 |
Átlagok az ellenőrzőpontokon: v28 0,846 · best-of-3 0,879 · referencia 0,782.
Vak értékelés: a bíráló zajosságán belül
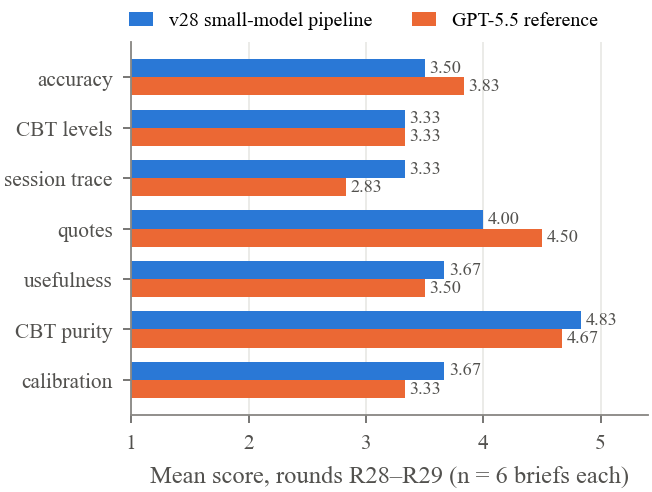
A végső körökben a kis modell legjobb verziója és a referencia 3,77, illetve 3,87 pontot kapott (R28), majd 3,77, illetve 3,57 pontot (R29). Hat, azonos körön belüli pár esetén a különbség −0,4; +0,2; −0,1; −0,5; +0,9; +0,2 volt: átlag +0,05, SD 0,49. Egyik rendszer sem érte el a felügyelő 4,0-s célátlagát. Szempontonként a v28 jobb volt az ülésmenet követésében és a kalibrációban, gyengébb a pontosságban (az arany standard referenciával való egyezésben) és az idézetekben, a CBT-szintek tekintetében pedig azonos szinten állt.
Költség
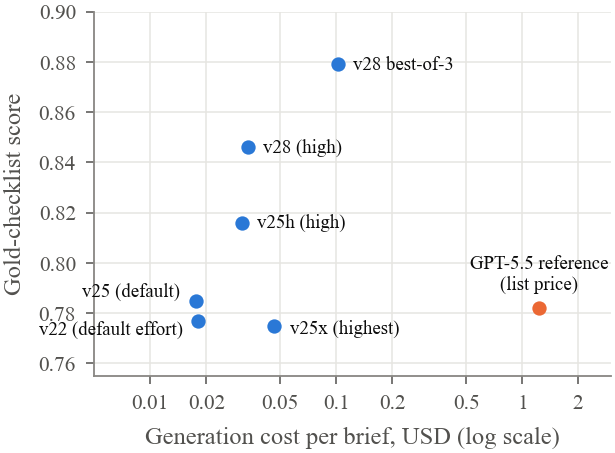
Egy v28-as összefoglaló elkészítése körülbelül USD 0,03-be kerül a szakaszok megírásával együtt, és 2,5–3 percet vesz igénybe; egy best-of-3 összefoglaló körülbelül USD 0,11-be. Egy új ülés feldolgozása további körülbelül USD 0,07, főként azért, mert a klasszifikátor minden mondatot feldolgoz. Listaárakon a frontier referencia-összefoglaló körülbelül 19-szer annyiba kerül, mint egyetlen v28-as összefoglaló. A teljes projekt 5,57 USD értékű kis modell tokenjeit használta fel.
Mi segített, és mi nem
Három dolog segített: a felügyelő által észlelt, determinisztikus kódbeli hibák kijavítása; a szakaszírók magas következtetési erőfeszítési beállítása (a legmagasabb beállítás drágább volt, és alacsonyabb pontszámot adott); valamint a javasolt napirend, az előrejelzési sáv és a legutóbbi, kockázattal kapcsolatos kijelentés kódba helyezése. Több hihetőnek tűnő kiegészítés rontott az eredményen: három vázlat összevonása, kóddal előírt hiedelem-idővonal, lefedettség-helyreállító lépéssel kombinált fontossági útmutatás, valamint rubrika alapján végzett önrevízió. Mindegyik olyan generálási lépéssel járt, amelyben a kis modell információt veszíthet vagy torzíthat. Biztonságosnak bizonyult minden olyan változtatás, amely kivette a feladatot a modell kezéből, vagy átírás nélkül választott a kimenetek közül.
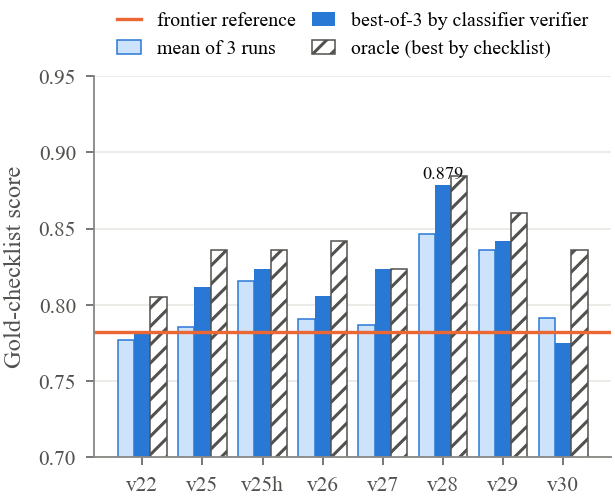
A verifieres kiválasztás a nyolc verzió közül hétnél javította az ellenőrzőlista-pontszámot; a v28-nál 0,846-ról 0,879-re emelte, ami közel áll az orákulum értékéhez (0,885). Mivel a verifier és az ellenőrzőlista pontozója ugyanaz a klasszifikátor, a javulás egy része közös preferenciákat tükrözhet.
Mi maradt nehéz
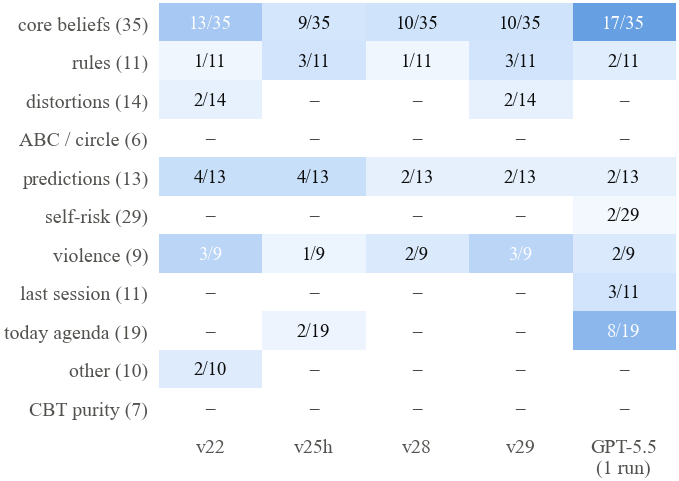
A tartós hibák száma a v22 és a v28 között 25-ről 15-re csökkent a 164 súlyegységből. A fennmaradó hibák a kognitív modell legfinomabb megítéléseihez kapcsolódnak: mi történik egy hiedelemmel annak újbóli aktiválása után; olyan hiedelemtartományok, amelyek a legfrissebb anyag előtt véget érnek; valamint a hatókörre vonatkozó megszorítások. A kockázattal kapcsolatos mondatok feldolgozása bizonyult a legnehezebbnek: a közelmúltbeli kijelentések kihagyását és a metafora, gyakorlat vagy érzelmi értékelés jelzésként való kezelését is büntettük. A legjobb megoldás csak a legutóbbi szó szerinti kijelentést, valamint azt az ülést tartotta meg, amelyen a terapeuta utoljára közvetlenül rákérdezett erre, az értelmezést pedig teljes egészében a terapeutára bízta.
A bíráló is a kísérlet része
Mivel a referencia-összefoglaló sosem változott, a pontszámai csak a felügyelőt mérik.
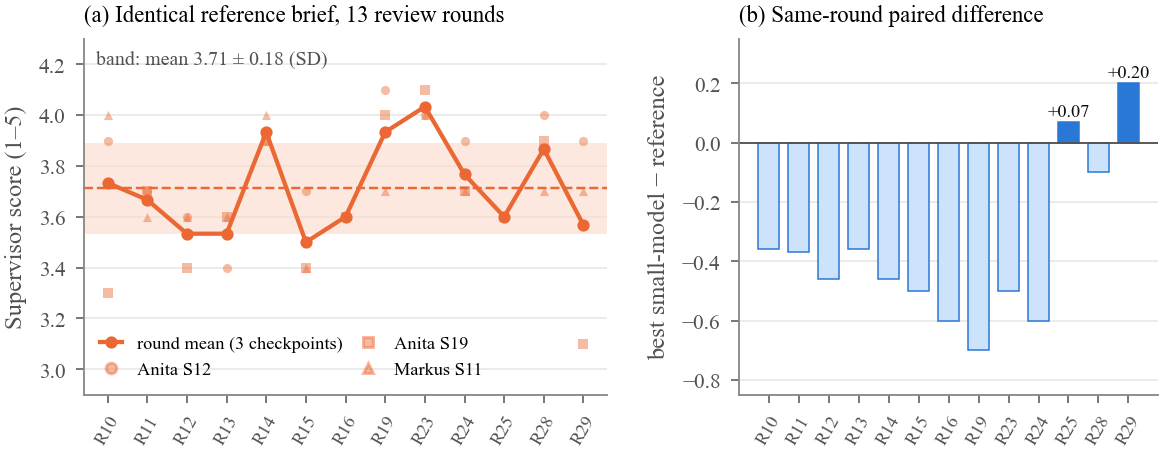
13 kör során az azonos referencia-összefoglaló körönkénti átlaga 3,71, SD-je 0,18, tartománya pedig 3,50–4,03 volt az 1–5-ös skálán. Egyes szempontoknál az SD elérte a 0,46-ot, többek között az olyan idézetek esetében is, amelyeket szkripttel ellenőriztünk, és amelyek minden alkalommal azonosak voltak. Ez a zaj nagyjából akkora, mint a ciklus által ugyanezen a skálán elért teljes javulás.
Mit nem mutat meg ez a tanulmány
- Kizárólag szintetikus adatok. Két szintetikus páciens, három ellenőrzőpont, verziónként három futás. Csak leíró statisztikákat közlünk, szignifikanciateszteket nem. Az eredmények más feladatokra és valós anyagokra való átvihetősége érvelés tárgya, nem bizonyított.
- Kizárólag modellekkel végzett értékelés. A tervezésnek megfelelően klinikusok és más emberi értékelők nem vettek részt. A pontszámok az arany standardként szolgáló ellenőrzőlistával való egyezést, valamint egy LLM-felügyelő értékelését tükrözik; nem klinikai minőséget, biztonságosságot vagy a terápiára gyakorolt bármilyen hatást.
- Az értékelési adathalmazon végzett hangolás. Minden verzió ugyanazon ellenőrzőpontok és bírálók alapján készült, ezért a végső pontszámok optimisták. A megfelelő teszt egy visszatartott páciens lenne.
- A megkülönböztethetetlenség nem jelent jobbat. A vak értékelésben ekkora mintánál nem lehetett megkülönböztetni a kis modellt és a frontier referenciát; a különbségek a bíráló saját zajosságán belül vannak.
- Közös klasszifikátor. Az ellenőrzőlista pontozója, a mondatokat vizsgáló rendszer és a verifier ugyanaz a modell.
- Szerény referencia. A frontier referencia egy korábbi, nem optimalizált pipeline egyszeri futtatása GPT-5.5-tel, nem pedig ugyanazzal a ciklussal hangolt frontier pipeline.
Olvassa el a tanulmányt, ellenőrizze a számokat
A teljes tanulmány ingyenesen letölthető. Az ellenőrzőlistákat, pontszámokat és példákat tartalmazó adatcsomagot e-mailben küldjük el.
A tanulmány
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 oldal, 9 ábra.
Az adatcsomag letöltése
A tanulmány PDF-je, mind a kilenc ábra, a három gold checklist, minden verzió ellenőrzőlista- és verifier-pontszámai, az utolsó körök vak értékelései a betűjeleikkel együtt, valamint három végső mintapélda. A README ismerteti az egyes mezőket.
Nem adjuk tovább az e-mail-címeket. Az adatcsomag linkje néhány percen belül megérkezik.
Mi található a ZIP-ben
paper/: a tanulmány PDF-formátumbanfigures/: kilenc ábra és a mögöttük álló számadatokscores/gold_checklists.json: 3 × 25 súlyozott állításscores/checklist_results.json: 198 értékelt összefoglaló elemenkénti valószínűségi értékeiscores/blind_review_R28.json,R29: hét szempont, értékelések és kifogások, a betűjelekkel együttexample-briefs/: három végleges v28-as összefoglaló (lengyelül, akárcsak az átiratok)
Nincsenek mellékelve: szintetikus átiratok, promptok és kód. Kutatási célból, kérésre a szerzőktől érhetők el.
Hivatkozás
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}