Mazs modelis, rūpīgi izstrādāts konveijers
Autopētījuma metode, lai mazinātu atšķirību no vadošajiem LLM gariem, vairākos dokumentos izkliedēta materiāla apkopošanā. Pārbaudīta pirms sesijas sagatavotajos pārskatos, kas veidoti no divu sintētisku pacientu transkriptiem.
Lēts modelis var pietuvoties, ja tam liek darīt mazāk
Vadošie valodas modeļi labi apkopo garu, vairākos dokumentos izkliedētu materiālu, taču to izmantošana pirms katra rezultāta sagatavošanas izmaksā dārgi. Mazie modeļi ir lēti, bet garos ievaddatos zaudē informāciju. Mēs pētījām, cik tālu var tikt lēts modelis, ja to iekļauj rūpīgi izstrādātā konveijerā un pilnveido ar automatizētu cilpu, kas katru izmaiņu novērtē ar citiem modeļiem, neizmantojot cilvēku vērtētājus.
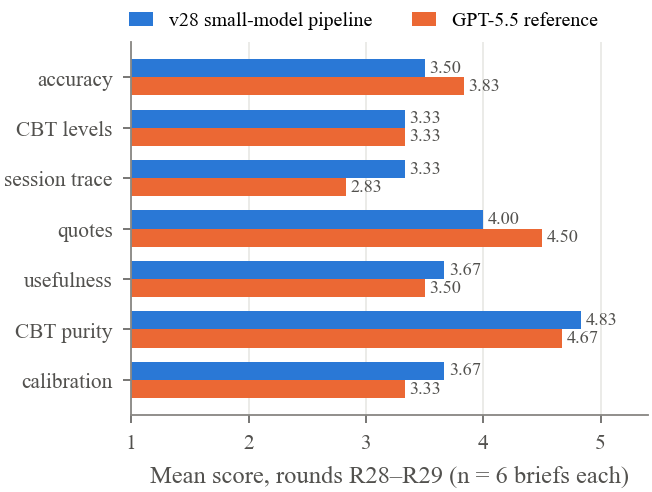
Vairāk nekā 30 versijās un 16 aklās pārskatīšanas kārtās mazā modeļa rezultāts svērtajā kontrolsarakstā ar zelta standarta atbildēm pieauga no 0,647 līdz 0,846 (0,879, ja no trim palaišanas reizēm izvēlas labāko, izmantojot verifier, kam nav pieejama atsauce). Vadošā modeļa atsauces rezultāts bija 0,782. Aklajā pārskatīšanā, ko veica LLM uzraugs, šajā izlasē abus modeļus nevarēja atšķirt: pāru vidējā starpība bija +0,05 (SD 0,49). Tas pats, nemainītais atsauces pārskats no šī uzrauga saņēma vērtējumu no 3,50 līdz 4,03 13 kārtās, tāpēc paša vērtētāja svārstīgums izrādījās arī patstāvīgs pētniecības rezultāts.
Saturs
Garš ievaddatu kopums, fiksēta struktūra, regulāra lietošana
Daudziem praktiskiem apkopošanas uzdevumiem ir trīs kopīgas iezīmes: ievaddati ir gari un izkliedēti vairākos dokumentos, rezultāts atbilst fiksētai struktūrai ar skaitļiem, datumiem un burtiskiem pierādījumiem, un tas tiek sagatavots regulāri, tāpēc izmaksām ir nozīme.
Par pārbaudes vidi izvēlējāmies vienu šādu uzdevumu: strukturētu pārskatu, ko KBT terapeits pirms sesijas var izlasīt aptuveni trīs minūtēs. Tajā uzskaitīti pamatuzskati un to biežums sesijās, noteikumi, atkārtoti izziņas izkropļojumi, raksturīgas ABC epizodes, pārbaudītās prognozes, pēdējā sesija un jautājumi, ko terapeits varētu vēlēties pārrunāt šodienas sesijā. Līdz 20. sesijai materiāla apjoms sasniedz aptuveni 130 000 vārdu.
Šis uzdevums ir piemērots metožu izpētei, jo tam ir zināma struktūra (Beka kognitīvais modelis), dabisks pārbaudāmu pierādījumu avots (pacienta burtiski izteikumi) un vairāki riski: uzskats, kuru sākotnēji formulējis terapeits, vai metafora, kas nav apgalvojums par nāvi.
Divi sintētiski pacienti
Abi pacienti tika ģenerēti, izmantojot mūsu slāņaino sintētisko pacientu metodi (vispirms profila lapu, terapeitisko virzību, sesiju plānu un balss vadlīnijas, pēc tam sesijas tika ģenerētas pa vienai kā ASR tipa transkripti). Anita: 20 sesijas, 131 498 vārdi, J. Beka stila KBT. Markus: 12 sesijas, 83 978 vārdi; viņa terapeits daļēji strādā shēmu terapijā, tāpēc pārskatā materiāls jāpārveido KBT terminos. Katram pacientam atsauces pārskats ar zelta standarta atbildēm tika izveidots neatkarīgi, pilnībā izlasot transkriptus. Reālu pacientu dati netika izmantoti.
Darba sadalījums
Izšķirošās izmaiņas nebija labākas uzvednes, bet gan pienākumu pārdale. Katrs komponents dara tikai to, ko prot labi.
Deterministisks kods
Viss, ko var saskaitīt, sakārtot vai pārbaudīt
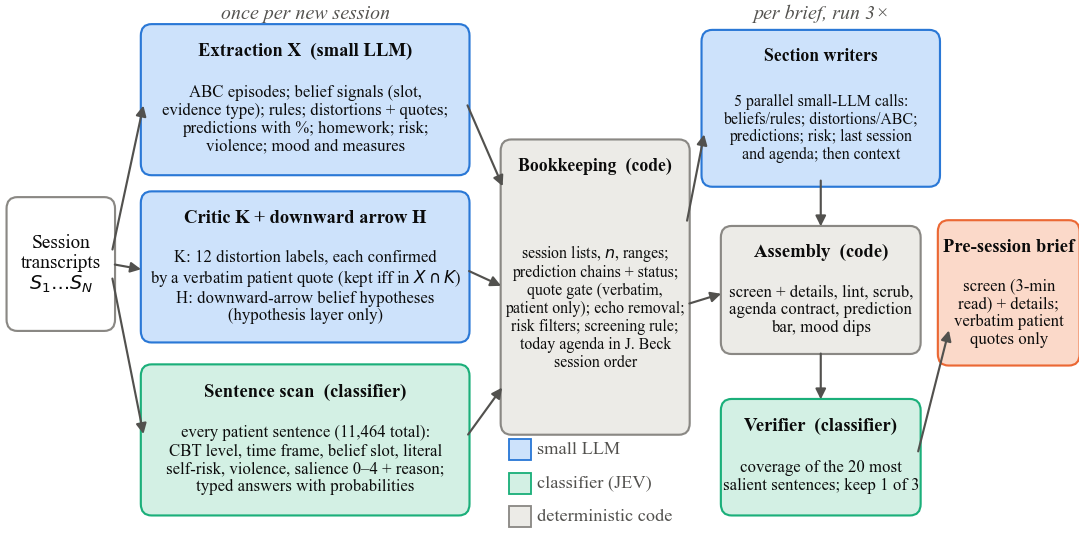
Sesiju saraksti, katra uzskata skaits un diapazons; prognožu ķēdes, kas sasaistītas starp sesijām; burtisku citātu filtrs, kas atmet jebkuru citātu, kurš nav atrodams paša pacienta teiktajā; terapeita atkārtojumu izņemšana; un, sākot ar 28. versiju, šodienas sesijai ierosināto punktu secība. Kad šajā kodā tiek atrasta kļūda, tā tiek izlabota un vairs neatgriežas.
Teikumu klasifikators
Vērtējumi, kam nav vajadzīga teksta ģenerēšana
Katrs pacienta teikums (kopā 11 464) tiek marķēts vienu reizi: KBT līmenis (automātiska doma, noteikums, uzskats, emocija, uzvedība…), laika perspektīva (tagad vai atmiņas), burtiska vai tēlaina izteiksme un iespējamā nozīmība nākamajai sesijai — katram piešķirot varbūtību. Tas pats klasifikators vēlāk kalpo gan par atsauces ziņā neatkarīgu verifier, gan kontrolsaraksta vērtētāju.
Mazs valodas modelis
Īsi teksti no sagatavota materiāla
Katrai sesijai mazais modelis izvelk struktūru, apstiprina izkropļojumus ar burtiskiem citātiem un piedāvā hipotēzes (tās tiek glabātas kā hipotēzes, nevis kā pierādījumi). Katram pārskatam paralēli darbojas pieci sadaļu veidotāji; katrs redz tikai savas sadaļas datus ar sesiju numuriem, un tam norādīts nekad neizdomāt sesiju numurus vai citātus.
Labākais no trim, neskatoties uz atbildi
Atšķirības starp viena modeļa versijas palaišanas reizēm bieži bija lielākas nekā atšķirības starp versijām. Tāpēc pārskata konveijers tiek palaists trīs reizes, un verifier izvēlas vienu rezultātu: tas atlasa 20 pacientam nozīmīgākos teikumus un vaicā klasifikatoram, vai katrs no tiem ir atspoguļots pārskatā. Verifier neredz atsauci ar zelta standarta atbildēm vai kontrolsarakstu.
Autopētījuma cilpa
Automatizēta izstrādes cilpa, kas līdzinās neseniem automatizētu eksperimentu pētījumiem: ierosina vienu izmaiņu, to izmēģina un saglabā tikai tad, ja sakrīt divi neatkarīgi rādītāji.
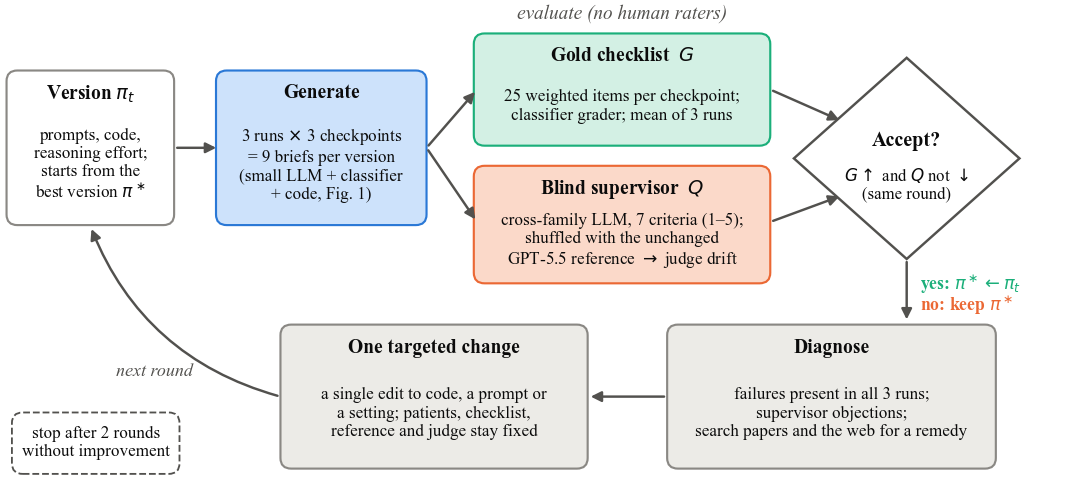
- Divi rādītāji. Klasifikatora vērtēts kontrolsaraksts ar zelta standarta atbildēm — 25 svērti apgalvojumi katrā kontrolpunktā — un akla pārskatīšana, ko veic citas modeļu saimes LLM uzraugs un kurā septiņi kritēriji tiek vērtēti skalā no 1 līdz 5.
- Fiksēts atskaites punkts. Uzraugs vienmēr redz arī vienu nemainītu atsauces pārskatu, kas apzīmēts ar nejauši izvēlētu burtu, tāpēc katrā kārtā tiek mērītas arī paša vērtētāja novirzes.
- Pa vienai izmaiņai. Katrā kārtā tiek veikta viena mērķēta izmaiņa, ko nosaka kļūdas, kas ir visās trīs palaišanas reizēs, un uzrauga iebildumi, izmantojot literatūras meklēšanas rezultātus.
- Fiksēts apturēšanas noteikums. Divas secīgas kārtas bez uzlabojumiem beidz cilpu. Tā tika apturēta pie v28.
- Fiksēts izmaksu ierobežojums. Konveijerā nedrīkst izmantot modeli, kas ir dārgāks par mazo modeli vai klasifikatoru.
Ko mēs novērojām
Aprakstošā statistika par trim kontrolpunktiem (Anita pirms 13. un 20. sesijas, Markus pirms 12. sesijas) un trim katras versijas palaišanas reizēm.
Satura pārklājums: kontrolsaraksts ar zelta standarta atbildēm
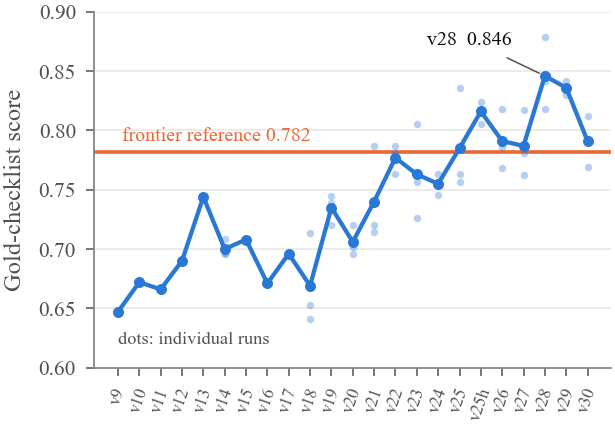
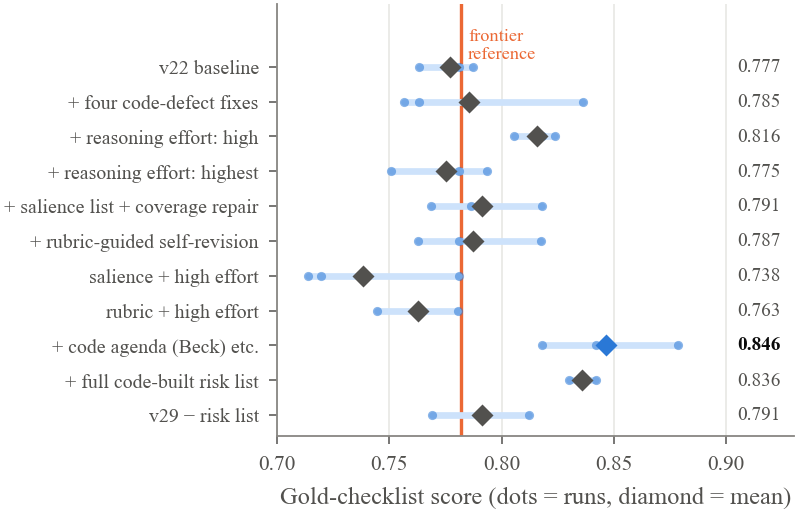
Mazā modeļa sākotnējais rezultāts bija ievērojami zemāks par atsauces rezultātu (0,647 pret 0,782); v25 tas to pārsniedza un v28 sasniedza 0,846. Visu trīs v28 palaišanas reižu rezultāti (0,818, 0,842, 0,879) bija augstāki par atsauces rezultātu. Divas nākamās versijas v28 neuzlaboja, un cilpa tika apturēta.
| Anita, pirms S13 | Anita, pirms S20 | Markus, pirms S12 | |
|---|---|---|---|
| v28, 3 palaišanas reižu vidējais | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verifier) | 0,963 | 0,836 | 0,836 |
| GPT-5.5 atsauce (1 palaišanas reize) | 0,963 | 0,655 | 0,727 |
Vidējie rādītāji kontrolpunktos: v28 0,846 · best-of-3 0,879 · atsauce 0,782.
Akla pārskatīšana: vērtētāja svārstību robežās
Pēdējās kārtās labākā mazā modeļa versija un atsauce saņēma attiecīgi 3,77 pret 3,87 (R28) un 3,77 pret 3,57 (R29). Sešos vienas kārtas pāros starpība bija −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: vidējais +0,05, SD 0,49. Neviena sistēma nesasniedza uzrauga mērķa vidējo vērtējumu 4,0. Kritēriju griezumā v28 bija labāks sesiju izsekojamībā un kalibrācijā, sliktāks precizitātē (saskaņā ar atsauci ar zelta standarta atbildēm) un citātos, bet līdzvērtīgs KBT līmeņu ziņā.
Izmaksas
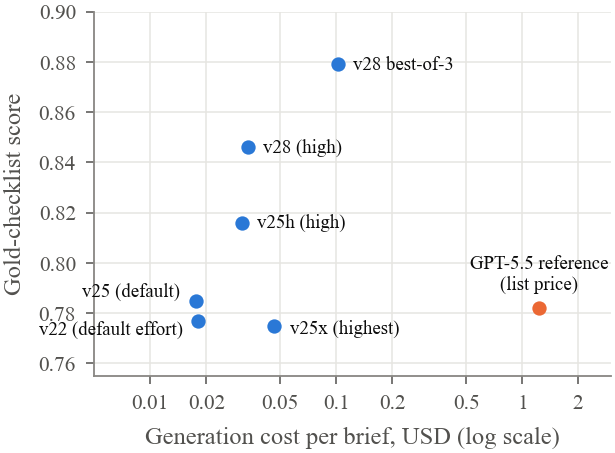
Viena v28 pārskata sadaļu teksta sagatavošana izmaksā aptuveni USD 0,03 un aizņem 2,5–3 minūtes; best-of-3 pārskats izmaksā aptuveni USD 0,11. Jaunas sesijas apstrāde izmaksā vēl aptuveni USD 0,07, galvenokārt tāpēc, ka klasifikators apstrādā katru teikumu. Pēc cenrāža vadošā modeļa atsauces pārskats izmaksā aptuveni 19 reizes vairāk nekā viens v28 pārskats. Visā projektā mazo modeļu tokeniem tika iztērēti USD 5,57.
Kas palīdzēja un kas ne
Palīdzēja trīs lietas: deterministiskā koda kļūdu labošana, kuras atklāja uzraugs; sadaļu veidotājiem iestatīts augsts spriešanas intensitātes līmenis (augstākais līmenis izmaksāja vairāk un deva zemāku rezultātu); un šodienai ierosinātās darba kārtības, prognožu joslas un jaunākā ar risku saistītā apgalvojuma pārvietošana uz kodu. Vairāki šķietami lietderīgi papildinājumi pasliktināja rezultātu: trīs melnrakstu apvienošana, koda noteikta uzskatu laika skala, nozīmīguma norādes kopā ar pārklājuma labošanas soli un pašpārskatīšana pēc vērtēšanas kritērijiem. Katrs no tiem pievienoja ģenerēšanas soli, kurā mazs modelis var zaudēt vai sagrozīt informāciju. Drošas izrādījās visas izmaiņas, kas samazināja modeļa veicamo darbu vai atlasīja rezultātu, to nepārrakstot.
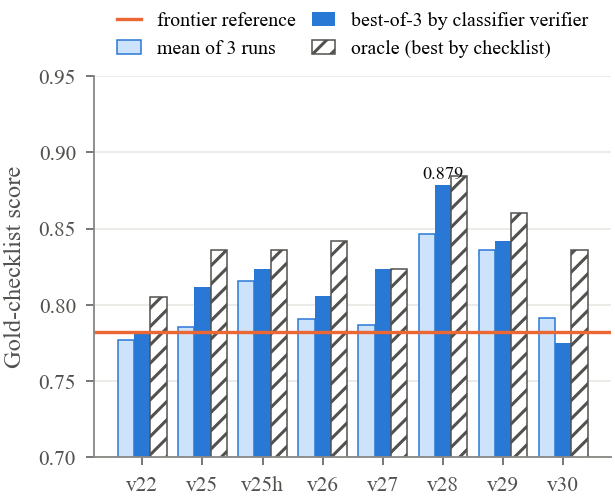
Verifier atlase uzlaboja kontrolsaraksta rezultātu septiņās no astoņām versijām; v28 gadījumā — no 0,846 līdz 0,879, tuvu orākula rezultātam (0,885). Tā kā verifier un kontrolsaraksta vērtētājs ir viens un tas pats klasifikators, daļu no šī pieauguma var izskaidrot kopīgās preferences.
Kas joprojām sagādāja grūtības
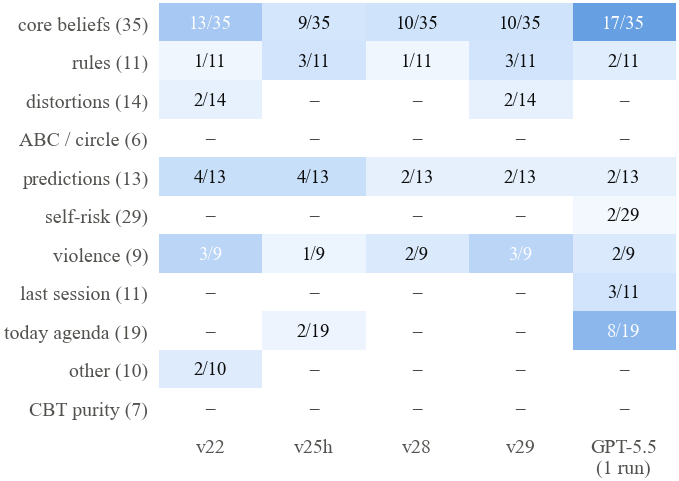
Noturīgo kļūdu skaits no v22 līdz v28 samazinājās no 25 līdz 15 no 164 svēruma vienībām. Atlikušās problēmas ir vissmalkākie kognitīvā modeļa vērtējumi: uzskata stāvoklis pēc tā atkārtotas aktivizēšanas, uzskatu diapazoni, kas beidzas pirms jaunākā materiāla, un tvēruma precizējumi. Visgrūtākā sastāvdaļa bija teikumi par risku: tika sodīta gan nesena apgalvojuma neiekļaušana, gan metaforas, vingrinājuma vai emociju vērtējuma pārvēršana par signālu. Labākajā risinājumā tika paturēts tikai jaunākais burtiskais apgalvojums un sesija, kurā terapeits pēdējoreiz tieši par to jautāja, bet visas interpretācijas tika atstātas terapeitam.
Vērtētājs ir daļa no eksperimenta
Tā kā atsauces pārskats nekad nemainījās, tā vērtējumi atspoguļo tikai uzrauga darbību.
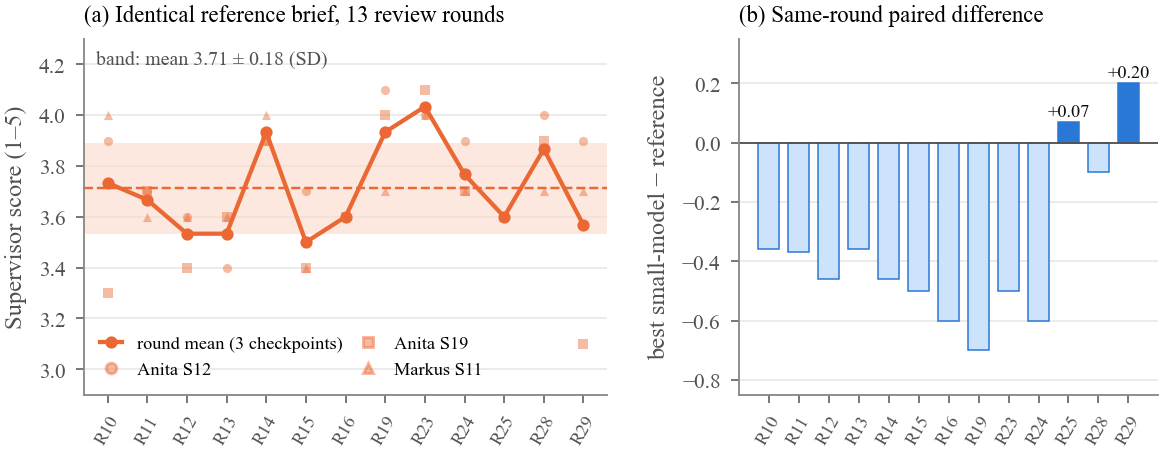
13 kārtās identiskais atsauces pārskats saņēma vidējo vērtējumu 3,71 ar SD 0,18 un diapazonu 3,50–4,03 skalā no 1 līdz 5. Atsevišķiem kritērijiem SD sasniedza 0,46, tostarp citātu kritērijam, kurā citāti bija pārbaudīti ar skriptu un katru reizi identiski. Šis svārstīgums ir aptuveni tikpat liels kā viss cilpas panāktais uzlabojums tajā pašā skalā.
Ko šis pētījums nepierāda
- Tikai sintētiski dati. Divi sintētiski pacienti, trīs kontrolpunkti, trīs katras versijas palaišanas reizes. Tikai aprakstošā statistika, bez nozīmīguma testiem. Pārnese uz citiem uzdevumiem un reāliem materiāliem tiek argumentēta, nevis pierādīta.
- Tikai modeļos balstīta novērtēšana. Pēc ieceres nepiedalījās klīnicisti vai citi cilvēku vērtētāji. Vērtējumi raksturo atbilstību kontrolsarakstam ar zelta standarta atbildēm un LLM uzrauga vērtējumu, nevis klīnisko kvalitāti, drošumu vai jebkādu ietekmi uz terapiju.
- Pielāgots vērtēšanas kopai. Visas versijas tika izstrādātas, izmantojot tos pašus kontrolpunktus un vērtētājus, tāpēc galīgie rezultāti ir optimistiski. Pareizais pārbaudījums būtu iepriekš neizmantots pacients.
- Neatšķirams nenozīmē labāks. Aklajā pārskatīšanā šajā izlasē mazo modeli un vadošā modeļa atsauci nevarēja atšķirt; starpības ir paša vērtētāja svārstīguma robežās.
- Kopīgs klasifikators. Kontrolsaraksta vērtētājs, teikumu analizētājs un verifier ir viens un tas pats modelis.
- Pieticīga atsauce. Atsauce uz vadošo modeli ir viena agrāka, neoptimizēta konveijera palaišanas reize ar GPT-5.5, nevis vadošā modeļa konveijers, kas pielāgots ar to pašu cilpu.
Lasiet rakstu, pārbaudiet skaitļus
Pilno rakstu var lejupielādēt bez maksas. Datu pakotni ar kontrolsarakstiem, rezultātiem un pārskatu piemēriem nosūtām pa e-pastu.
Raksts
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Priekšpublicējums, 13 lappuses, 9 attēli.
Lejupielādēt datu pakotni
Raksta PDF, visi deviņi attēli, trīs kontrolsaraksti ar zelta standarta atbildēm, visu versiju kontrolsarakstu un verifier rezultāti, pēdējo kārtu aklās pārskatīšanas rezultāti ar burtu atslēgām un trīs galīgo pārskatu piemēri. README failā izskaidrots katrs lauks.
Mēs adreses neizpaužam. Saite uz datiem pienāk dažu minūšu laikā.
ZIP faila saturs
paper/: raksts PDF formātāfigures/: deviņi attēli un pamatā esošie skaitļiscores/gold_checklists.json: 3 × 25 svērti apgalvojumiscores/checklist_results.json: katras vienības varbūtības 198 novērtētiem pārskatiemscores/blind_review_R28.json,R29: septiņi kritēriji, vērtējumi un iebildumi ar burtu atslēgāmexample-briefs/: trīs galīgie v28 pārskati (poļu valodā, tāpat kā transkripti)
Nav iekļauts: sintētiskie transkripti, uzvednes un kods. Pētniecības vajadzībām tos pēc pieprasījuma nodrošina autori.
Kā citēt
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}