Model petit, pipeline acurat
Un mètode d’autorecerca per reduir la diferència respecte dels LLM d’avantguarda en la síntesi llarga de diversos documents. Provat en resums previs a les sessions elaborats a partir de les transcripcions de dos pacients sintètics.
Un model barat pot acostar-s’hi si fa menys
Els models lingüístics d’avantguarda sintetitzen bé material llarg i compost de diversos documents, però fer-ne servir un abans de cada resultat és car. Els models petits són barats, però perden informació amb entrades llargues. Ens vam preguntar fins on pot arribar un model de baix cost quan s’integra en un pipeline dissenyat amb cura i es millora mitjançant un cicle automatitzat que avalua cada canvi amb altres models, sense avaluadors humans.
Al llarg de més de 30 versions i 16 rondes d’avaluació a cegues, la puntuació del model petit va passar de 0,647 a 0,846 en una llista de verificació de referència ponderada (0,879 quan un verificador sense accés a la referència tria la millor de tres execucions). La referència d’avantguarda va obtenir 0,782. En l’avaluació a cegues d’un supervisor LLM, no es van poder distingir els dos models amb aquesta mida de mostra: la diferència mitjana aparellada va ser de +0,05 (DE 0,49). El mateix resum de referència, sense canvis, va rebre puntuacions d’entre 3,50 i 4,03 d’aquest supervisor al llarg de 13 rondes, de manera que el soroll propi del jutge va resultar ser també una troballa.
Continguts
Entrada llarga, estructura fixa, ús habitual
Moltes tasques pràctiques de síntesi comparteixen tres característiques: l’entrada és llarga i està repartida entre molts documents, la sortida segueix una estructura fixa amb recomptes, dates i proves literals, i es produeix de manera habitual, de manera que el cost és rellevant.
Vam fer servir una tasca d’aquest tipus com a banc de proves: un resum estructurat que un terapeuta de TCC pot llegir en uns tres minuts abans d’una sessió. Enumera les creences centrals amb el nombre de sessions, les regles, les distorsions recurrents, els episodis ABC típics, les prediccions posades a prova, l’última sessió i els aspectes que el terapeuta pot voler abordar a la sessió d’avui. A la sessió 20, el material arriba a unes 130.000 paraules.
Aquesta tasca és adequada per a una pregunta metodològica perquè té una estructura coneguda (el model cognitiu de Beck), una noció natural de prova verificable (les paraules literals del pacient) i diverses possibles confusions: una creença formulada inicialment pel terapeuta o una metàfora que no és una afirmació sobre la mort.
Dos pacients sintètics
Tots dos pacients es van generar amb el nostre mètode de pacients sintètics per capes (primer, fitxa de perfil, arc terapèutic, pla de sessions i guia de veu; després, sessions generades una per una com a transcripcions d’estil ASR). Anita: 20 sessions, 131.498 paraules, TCC a l’estil de J. Beck. Markus: 12 sessions, 83.978 paraules, amb un terapeuta que treballa parcialment amb teràpia d’esquemes, de manera que cal traduir el material als termes de la TCC. Per a cada pacient, es va redactar una referència de referència a partir d’una lectura completa i independent de les transcripcions. No es van fer servir dades de pacients reals.
Repartiment de tasques
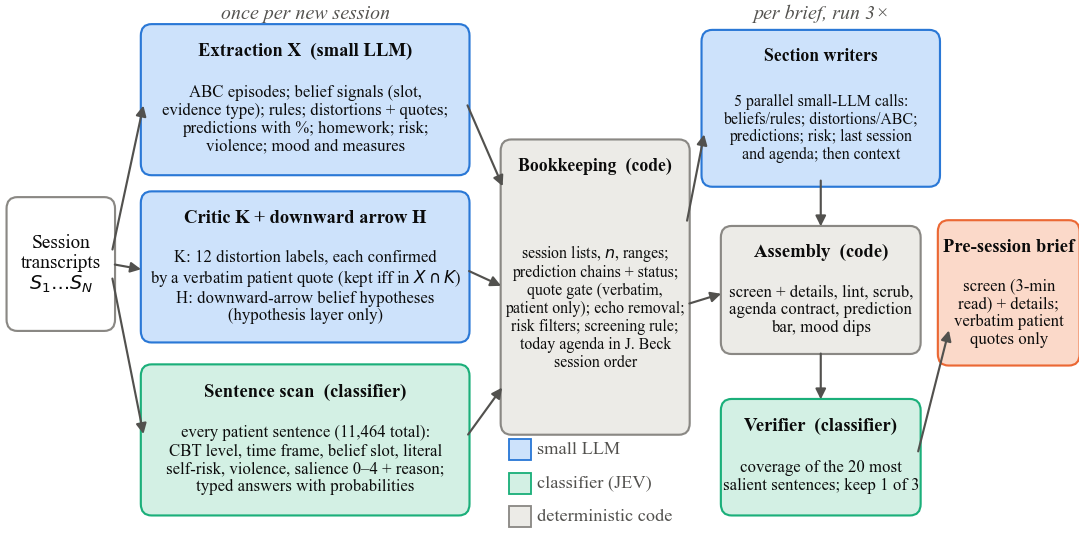
Els canvis decisius no van consistir a millorar les instruccions, sinó a redistribuir les responsabilitats. Cada component fa només allò que sap fer bé.
Codi determinista
Tot allò que es pot comptar, ordenar o comprovar
Llistes de sessions, recomptes i intervals per a cada creença; cadenes de prediccions enllaçades entre sessions; un filtre de cites literals que descarta les que no apareixen en les paraules del pacient; eliminació dels ecos del terapeuta; i, a partir de la versió 28, l’ordre dels punts suggerits per a la sessió d’avui. Un cop es detecta un defecte en aquest codi, es corregeix de manera permanent.
Un classificador de frases
Judicis que no requereixen generar text
Totes les frases del pacient (11.464 en total) es classifiquen una vegada: nivell de TCC (pensament automàtic, regla, creença, emoció, conducta…), marc temporal (actual o recordat), formulació literal o figurada i possible rellevància de la frase per a la sessió següent, cadascun amb una probabilitat. Més endavant, el mateix classificador fa de verificador sense referència i de corrector de la llista de verificació.
Un model lingüístic petit
Redacció breu a partir de material preparat
Per a cada sessió, el model petit n’extreu l’estructura, confirma les distorsions amb cites literals i proposa hipòtesis (que s’emmagatzemen com a hipòtesis, mai com a proves). Per a cada resum, cinc redactors de secció s’executen en paral·lel; cadascun només veu les dades numerades per sessió de la seva pròpia secció i rep instruccions de no inventar mai números de sessió ni cites.
La millor de tres, sense consultar la resposta
Les diferències entre execucions d’una mateixa versió sovint eren més grans que les diferències entre versions. Per això, el pipeline a nivell de resum s’executa tres vegades i un verificador en tria una: agafa les 20 frases més rellevants del pacient i demana al classificador si cadascuna hi està reflectida. El verificador no veu mai la referència de referència ni la llista de verificació.
El cicle d’autorecerca
Un cicle de desenvolupament automatitzat inspirat en els treballs recents sobre experimentació automatitzada: proposar un canvi, executar-lo i conservar-lo només si hi coincideixen dues mètriques independents.
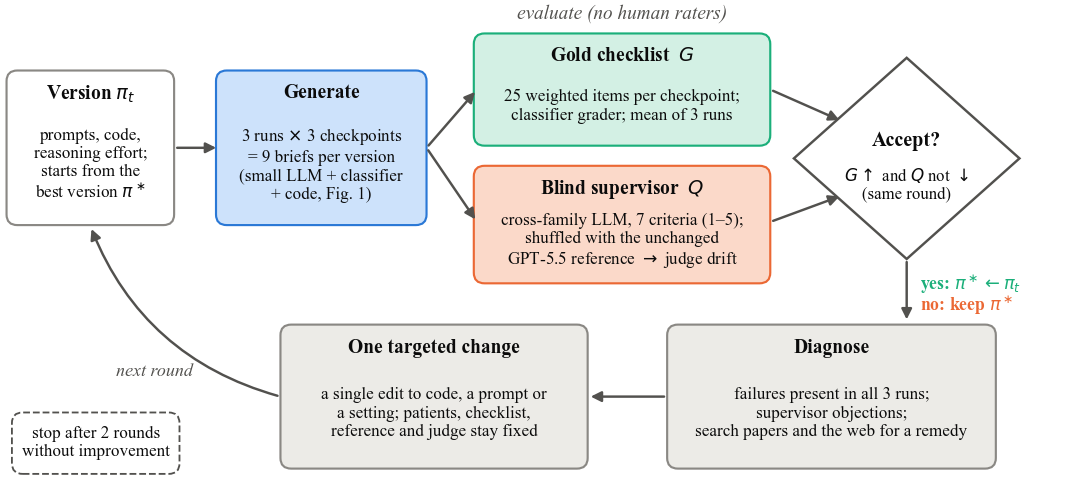
- Dues mètriques. Una llista de verificació de referència amb 25 afirmacions ponderades per punt de control, corregida pel classificador, i una avaluació a cegues d’un supervisor LLM d’una família de models diferent, que puntua set criteris en una escala d’1 a 5.
- Una referència fixa. El supervisor també veu sempre un resum de referència d’avantguarda sense canvis, amb una lletra aleatòria, de manera que en cada ronda es mesura la deriva del jutge.
- Un canvi cada vegada. Els errors presents en les tres execucions i les objeccions del supervisor motiven un canvi específic per ronda, informat per una cerca bibliogràfica.
- Una regla d’aturada fixa. Dues rondes consecutives sense millora posen fi al cicle. Es va aturar a v28.
- Un límit de cost fix. Dins del pipeline no es pot fer servir cap model que sigui més car que el model petit o el classificador.
Què vam observar
Estadístiques descriptives de tres punts de control (Anita abans de les sessions 13 i 20, Markus abans de la sessió 12) i tres execucions per versió.
Cobertura del contingut: la llista de verificació de referència
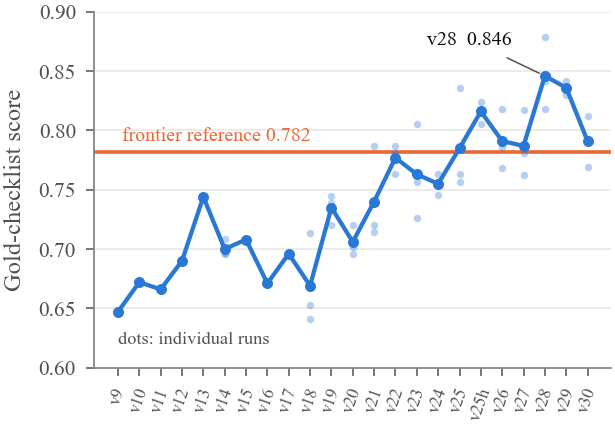
El model petit va començar força per sota de la referència (0,647 vs. 0,782), la va superar a v25 i va arribar a 0,846 a v28. Les tres execucions de v28 (0,818, 0,842, 0,879) superen la referència. Dues versions posteriors no van millorar v28 i el cicle es va aturar.
| Anita, abans de S13 | Anita, abans de S20 | Markus, abans de S12 | |
|---|---|---|---|
| v28, mitjana de 3 execucions | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (verificador) | 0,963 | 0,836 | 0,836 |
| Referència GPT-5.5 (1 execució) | 0,963 | 0,655 | 0,727 |
Mitjanes dels punts de control: v28 0,846 · best-of-3 0,879 · referència 0,782.
Avaluació a cegues: dins del marge de soroll del jutge
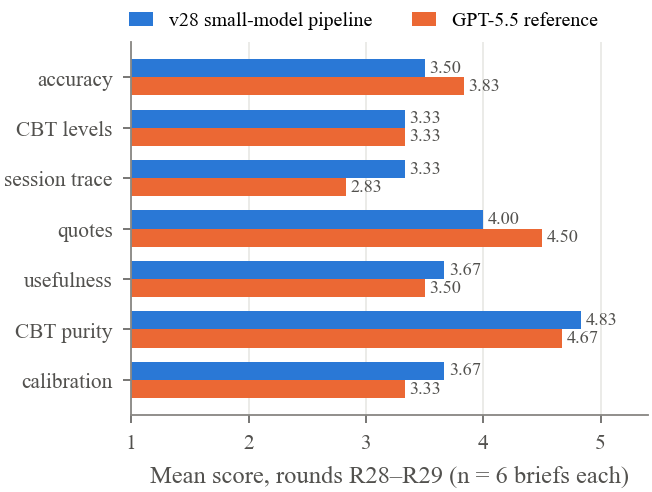
En les rondes finals, la millor versió del model petit i la referència van obtenir 3,77 vs. 3,87 (R28) i 3,77 vs. 3,57 (R29). En sis parelles de la mateixa ronda, les diferències van ser −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: mitjana +0,05, DE 0,49. Cap dels dos sistemes no va assolir la mitjana objectiu de 4,0 del supervisor. Per criteri, v28 va quedar per davant en el seguiment de les sessions i la calibració, per darrere en precisió (concordança amb la referència de referència) i cites, i al mateix nivell en els nivells de TCC.
Cost
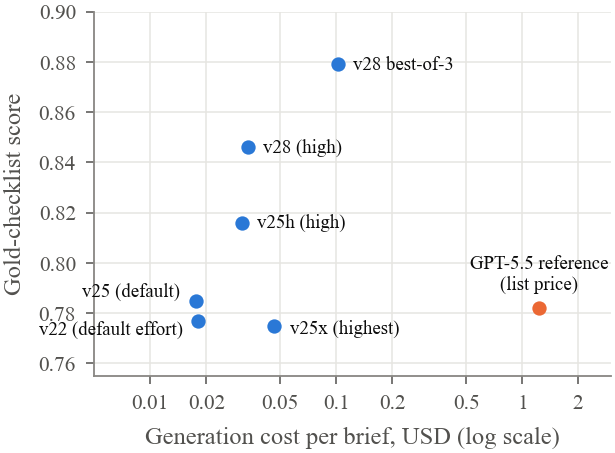
Un resum de v28 costa aproximadament USD 0,03 en redacció de seccions i triga entre 2,5 i 3 minuts; un resum best-of-3 costa uns USD 0,11. Processar una sessió nova afegeix uns USD 0,07, principalment pel pas del classificador per totes les frases. Als preus de llista, un resum de referència d’avantguarda costa unes 19 vegades més que un únic resum de v28. El projecte sencer va fer servir USD 5,57 en tokens del model petit.
Què va ajudar i què no
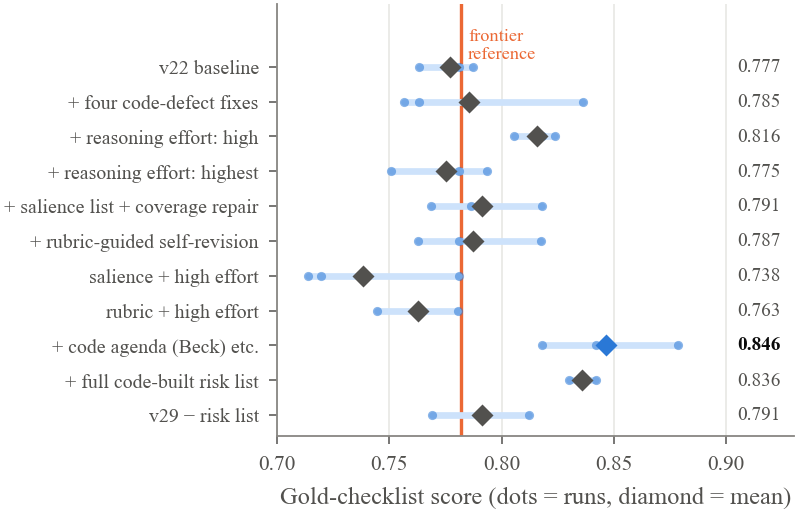
Tres coses van ajudar: corregir els defectes del codi determinista detectats pel supervisor, fer servir un nivell d’esforç de raonament alt per als redactors de secció (el nivell més alt va costar més i va obtenir una puntuació inferior) i traslladar a codi l’agenda suggerida, la barra de prediccions i l’afirmació més recent relacionada amb el risc. Diverses incorporacions plausibles van empitjorar els resultats: fusionar tres esborranys, imposar una cronologia de creences amb codi, afegir indicacions de rellevància amb una passada de reparació de cobertura i fer una autorevisió guiada per una rúbrica. Cadascuna hi va afegir un pas de generació en què un model petit pot perdre o distorsionar informació. Tots els canvis que treien feina al model o seleccionaven entre resultats sense reescriure’ls van ser segurs.
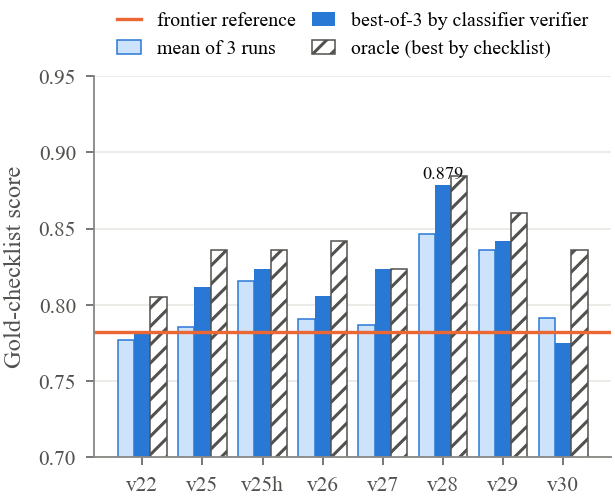
La selecció del verificador va millorar la puntuació de la llista de verificació en set de les vuit versions; en el cas de v28, de 0,846 a 0,879, a prop de l’oràcul (0,885). Com que el verificador i el corrector de la llista de verificació són el mateix classificador, part d’aquest guany pot reflectir preferències compartides.
Què continua sent difícil
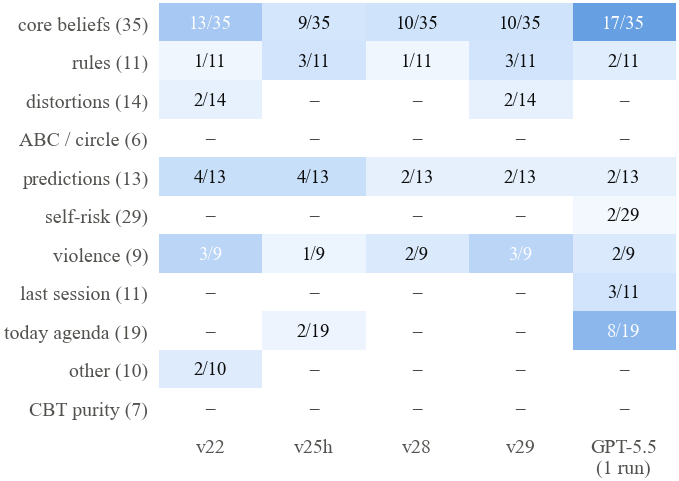
Els errors persistents van passar de 25 a 15 unitats de pes sobre 164 entre v22 i v28. El que queda són els judicis més subtils del model cognitiu: l’estat d’una creença després de reactivar-la, intervals de creences que no arriben al material més recent i matisos d’abast. Les frases sobre risc van ser el component més difícil: es van penalitzar tant l’omissió d’una afirmació recent com la conversió d’una metàfora, un exercici o una valoració d’emocions en un senyal. El millor disseny només conservava l’afirmació literal més recent i la sessió en què el terapeuta n’havia preguntat directament per última vegada, i deixava tota interpretació en mans del terapeuta.
El jutge forma part de l’experiment
Com que el resum de referència no va canviar mai, les seves puntuacions mesuren només el supervisor.
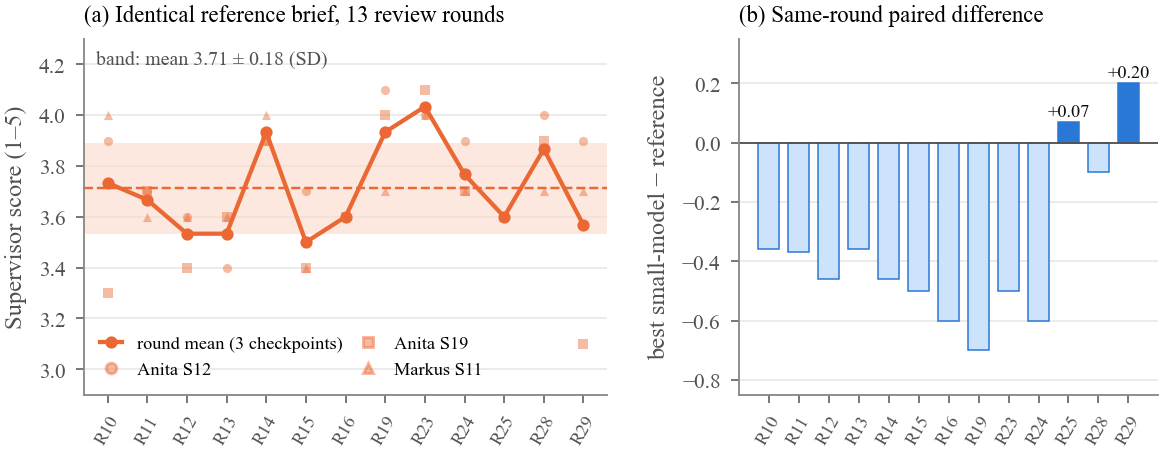
Al llarg de 13 rondes, el mateix resum de referència va obtenir una mitjana per ronda de 3,71, amb una DE de 0,18 i un interval de 3,50–4,03 en una escala d’1 a 5. En criteris individuals, la DE va arribar a 0,46, fins i tot per a cites verificades mitjançant script que eren idèntiques cada vegada. Aquest soroll és aproximadament tan gran com tota la millora que va produir el cicle en la mateixa escala.
Què no mostra aquest estudi
- Només dades sintètiques. Dos pacients sintètics, tres punts de control, tres execucions per versió. Només estadístiques descriptives, sense proves de significació. La transferència a altres tasques i a material real s’argumenta, però no es demostra.
- Només avaluació basada en models. Per disseny, no hi van participar clínics ni altres avaluadors humans. Les puntuacions descriuen la concordança amb una llista de verificació de referència i el judici d’un supervisor LLM, no la qualitat clínica, la seguretat ni cap efecte sobre la teràpia.
- Ajustat amb el conjunt d’avaluació. Totes les versions es van desenvolupar amb els mateixos punts de control i jutges, de manera que les puntuacions finals són optimistes. La prova adequada seria amb un pacient reservat.
- No distingibles no vol dir millors. En l’avaluació a cegues, no es van poder distingir el model petit i la referència d’avantguarda amb aquesta mida de mostra; les diferències es troben dins del marge de soroll del mateix jutge.
- Classificador compartit. El corrector de la llista de verificació, l’escàner de frases i el verificador són el mateix model.
- Una referència modesta. La referència d’avantguarda és una única execució anterior i no optimitzada del pipeline amb GPT-5.5, no un pipeline d’avantguarda ajustat amb el mateix cicle.
Llegeix l’article i comprova les xifres
L’article complet es pot descarregar gratuïtament. El paquet de dades amb llistes de verificació, puntuacions i resums d’exemple s’envia per correu electrònic.
L’article
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Prepublicació, 13 pàgines, 9 figures.
Descarrega el paquet de dades
PDF de l’article, les nou figures, les tres llistes de verificació de referència, les puntuacions de la llista de verificació i del verificador de cada versió, les avaluacions a cegues de les rondes finals amb les seves claus de lletres i tres resums finals d’exemple. Un README explica cada camp.
No compartim les adreces. L’enllaç a les dades arriba al cap d’uns minuts.
Què conté el ZIP
paper/: l’article en PDFfigures/: nou figures i les xifres que les sustentenscores/gold_checklists.json: 3 × 25 afirmacions ponderadesscores/checklist_results.json: probabilitats per element per a 198 resums avaluatsscores/blind_review_R28.json,R29: set criteris, veredictes i objeccions, amb les claus de lletresexample-briefs/: tres resums finals de v28 (en polonès, com les transcripcions)
No inclosos: transcripcions sintètiques, instruccions i codi. Els autors els poden facilitar a petició per a ús de recerca.
Com citar
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}