Väike mudel, hoolikalt kavandatud töövoog
Autoresearch-meetod, millega vähendada vahet tipptasemel LLM-idega pika, mitmest dokumendist koosneva kokkuvõtte koostamisel. Katsetatud kahe sünteetilise patsiendi transkriptsioonidest koostatud seansieelsete ülevaadetega.
Odav mudel võib jõuda lähedale, kui ta teeb vähem
Tipptasemel keelemudelid võtavad pika, mitmest dokumendist koosneva materjali hästi kokku, kuid iga väljundi eel ühe sellise mudeli käitamine läheb kulukaks. Väikesed mudelid on odavad, kuid kaotavad pika sisendi korral teavet. Uurisime, kui kaugele võib jõuda odav mudel, kui see paigutada hoolikalt kavandatud töövoogu ja seda täiustada automatiseeritud tsükliga, mis hindab iga muudatust teiste mudelite abil, ilma inimhindajateta.
Rohkem kui 30 versiooni ja 16 pimeda ülevaatuse vooru jooksul tõusis väikese mudeli skoor kaalutud kuldses kontrollnimekirjas 0.647-lt 0.846-ni (0.879, kui viitevaatest sõltumatu verifikaator valib kolmest käivitusest parima). Tipptaseme võrdlusmudeli skoor oli 0.782. LLM-järelevaataja tehtud pimedas ülevaatuses ei olnud neid selle valimi suuruse juures võimalik eristada: paaride keskmine erinevus oli +0.05 (SD 0.49). Sama muutmata võrdlusülevaade sai sellelt järelevaatajalt 13 vooru jooksul hindeid vahemikus 3.50–4.03, mistõttu osutus hindaja enda varieeruvus omaette uurimistulemuseks.
Sisukord
Pikk sisend, kindel struktuur, tavapärane kasutus
Paljudel praktilistel kokkuvõtteülesannetel on kolm ühist omadust: sisend on pikk ja jaotatud paljude dokumentide vahel, väljund järgib kindlat struktuuri koos loenduste, kuupäevade ja sõnasõnaliste tõenditega ning väljundit koostatakse korrapäraselt, mistõttu on oluline ka hind.
Kasutasime katselavana üht sellist ülesannet: struktureeritud ülevaadet, mille CBT-terapeut saab enne seanssi läbi lugeda umbes kolme minutiga. See loetleb põhiuskumused koos seansside arvuga, reeglid, korduvad mõtlemisvead, tüüpilised ABC-episoodid, kontrollitud ennustused, viimase seansi ning punktid, mida terapeut võiks tänasel seansil käsitleda. 20. seansiks on materjali maht umbes 130 000 sõna.
Ülesanne sobib meetodite uurimiseks, sest selle struktuur on teada (Becki kognitiivne mudel), kontrollitava tõendi loomulikuks allikaks on patsiendi sõnasõnalised väljendid ning esineb mitu lõksu: näiteks uskumus, mille sõnastas algselt terapeut, või metafoor, mis ei ole surma kohta käiv väide.
Kaks sünteetilist patsienti
Mõlemad patsiendid loodi meie kihilise sünteetilise patsiendi meetodiga (esmalt profiilileht, terapeutiline arengukaar, seansiplaan ja kõneviisi juhend, seejärel ükshaaval genereeritud seansid ASR-laadsete transkriptsioonidena). Anita: 20 seanssi, 131 498 sõna, J. Becki stiilis CBT. Markus: 12 seanssi, 83 978 sõna; tema terapeut kasutab osaliselt skeemiteraapiat, mistõttu tuleb ülevaates materjal CBT mõistetesse tagasi tõlkida. Iga patsiendi jaoks koostati kuldne võrdlus iseseisvalt, pärast transkriptsioonide täielikku läbilugemist. Päris patsientide andmeid ei kasutatud.
Tööjaotus
Otsustavad muudatused ei seisnenud paremates viipades, vaid vastutuse ümberjaotamises. Iga komponent teeb ainult seda, mida ta hästi oskab.
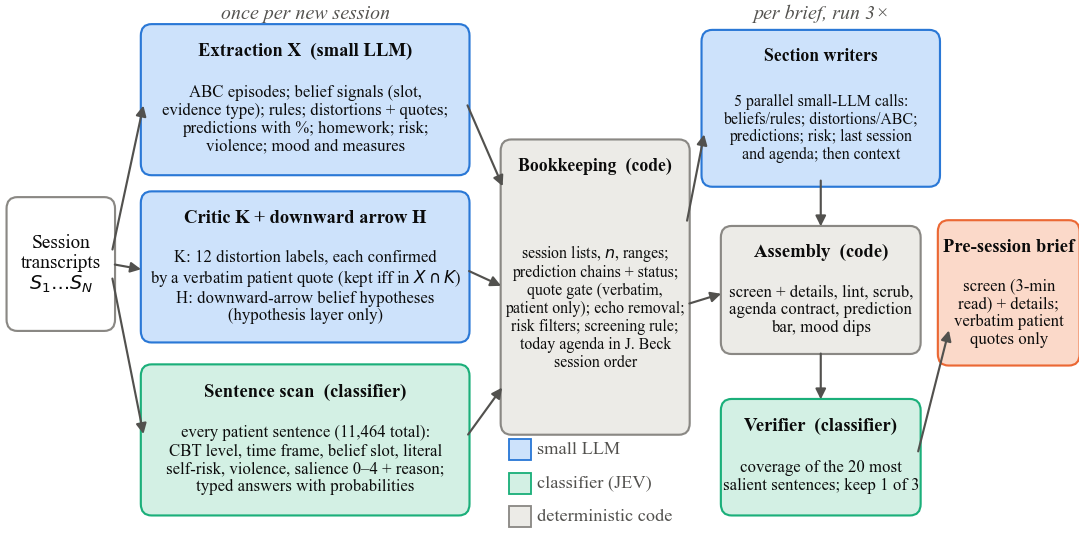
Deterministlik kood
Kõik, mida saab loendada, järjestada või kontrollida
Seansiloendid, uskumuste kaupa loendused ja vahemikud; seansse läbivad ennustusahelad; sõnasõnaliste tsitaatide filter, mis eemaldab kõik patsiendi enda ridadest leidmata tsitaadid; terapeudi kajastuste eemaldamine; ning alates versioonist 28 tänase seansi soovitatud punktide järjestus. Kui koodis leitakse viga, parandatakse see püsivalt.
Lauseklassifikaator
Hinnangud, mis ei nõua teksti genereerimist
Iga patsiendi lause (kokku 11 464) märgendatakse ühe korra: CBT tase (automaatmõte, reegel, uskumus, emotsioon, käitumine jne), ajaraam (praegu või meenutatud), sõnasõnaline või kujundlik sõnastus ning selle võimalik olulisus järgmisel seansil; igaühe juurde lisatakse tõenäosus. Sama klassifikaator toimib hiljem viitevaatest sõltumatu verifikaatorina ja kontrollnimekirja hindajana.
Väike keelemudel
Lühike tekst ettevalmistatud materjalist
Iga seansi kohta eraldab väike mudel struktuuri, kinnitab mõtlemisvead sõnasõnaliste tsitaatidega ja pakub hüpoteese (need salvestatakse hüpoteesidena, mitte kunagi tõenditena). Iga ülevaate jaoks käitatakse paralleelselt viit jaotise kirjutajat; igaüks näeb ainult oma jaotise seansinumbritega andmeid ning talle antakse juhis seansinumbreid ega tsitaate mitte kunagi välja mõelda.
Parim kolmest, vastust nägemata
Ühe versiooni käivitustevahelised erinevused olid sageli suuremad kui versioonidevahelised erinevused. Seetõttu käitab ülevaate töövoog protsessi kolm korda ja verifikaator valib ühe tulemuse: see võtab 20 kõige olulisemat patsiendi lauset ning küsib klassifikaatorilt, kas igaüks neist kajastub ülevaates. Verifikaator ei näe kuldset võrdlust ega kontrollnimekirja.
Autoresearch-tsükkel
Automatiseeritud arendustsükkel, mis lähtub hiljutistest automatiseeritud katsetamise töödest: paku välja üks muudatus, käivita see ja jäta alles ainult siis, kui kaks sõltumatut mõõdikut on kooskõlas.
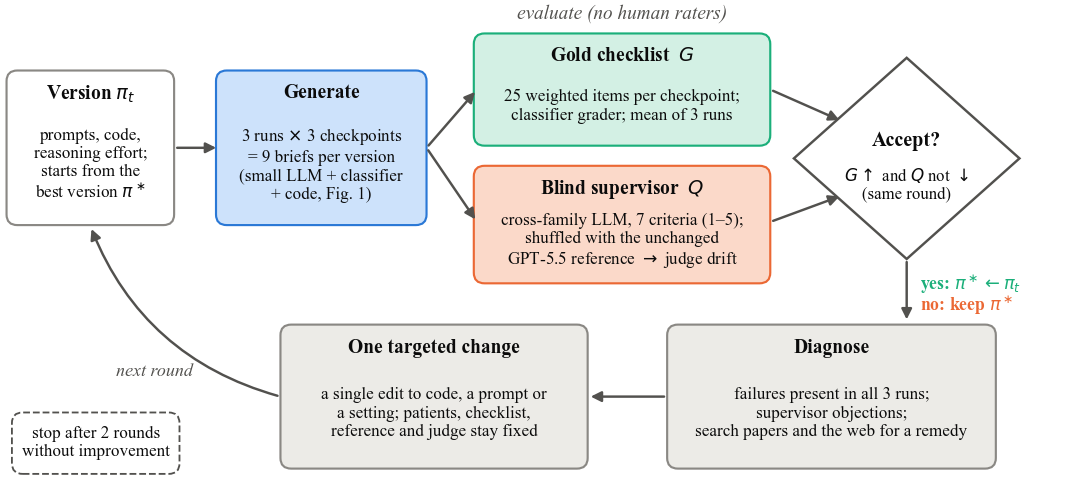
- Kaks mõõdikut. Iga kontrollpunkti jaoks 25 kaalutud väitega kuldne kontrollnimekiri, mida hindab klassifikaator, ning eri mudeliperest pärit LLM-järelevaataja pime ülevaatus, kus hinnatakse seitset kriteeriumi skaalal 1–5.
- Fikseeritud võrdluspunkt. Järelevaataja näeb alati ka üht muutmata tipptaseme võrdlusülevaadet juhusliku tähe all, et mõõta igas voorus hindaja enda triivi.
- Üks muudatus korraga. Kõigis kolmes käivituses esinevad vead ja järelevaataja vastuväited annavad ajendi üheks sihitud muudatuseks vooru kohta, mida suunab kirjanduse ülevaade.
- Fikseeritud lõpetamisreegel. Tsükkel lõpeb pärast kaht järjestikust vooru, kus paranemist ei toimu. See peatus versioonil v28.
- Fikseeritud kululagi. Töövoos ei tohi kasutada ühtegi mudelit, mis on kallim kui väike mudel või klassifikaator.
Mida täheldasime
Kirjeldav statistika kolmes kontrollpunktis (Anita enne 13. ja 20. seanssi, Markus enne 12. seanssi) ning kolm käivitust versiooni kohta.
Sisu katvus: kuldne kontrollnimekiri
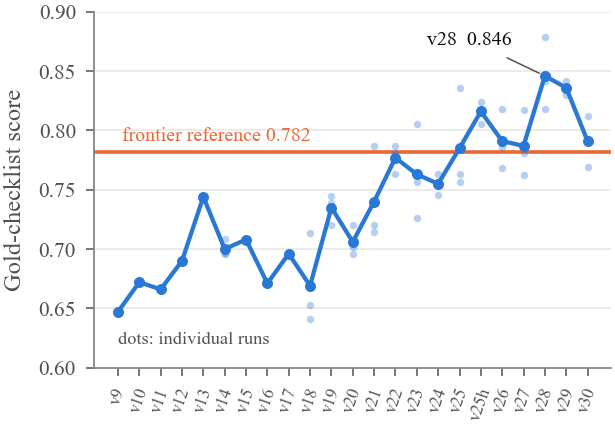
Väikese mudeli algne skoor oli võrdlusmudeli omast tunduvalt madalam (0.647 vs 0.782); versioonis v25 ületas see võrdlustaseme ja jõudis versioonis v28 väärtuseni 0.846. Kõik kolm v28 käivitust (0.818, 0.842, 0.879) ületavad võrdlusmudeli skoori. Kaks hilisemat versiooni ei parandanud v28 tulemust ning tsükkel peatati.
| Anita, enne S13 | Anita, enne S20 | Markus, enne S12 | |
|---|---|---|---|
| v28, 3 käivituse keskmine | 0.963 | 0.800 | 0.776 |
| v28, parim kolmest (verifikaator) | 0.963 | 0.836 | 0.836 |
| GPT-5.5 võrdlus (1 käivitus) | 0.963 | 0.655 | 0.727 |
Keskmised üle kontrollpunktide: v28 0.846 · parim kolmest 0.879 · võrdlus 0.782.
Pime ülevaatus: hindaja varieeruvuse piires
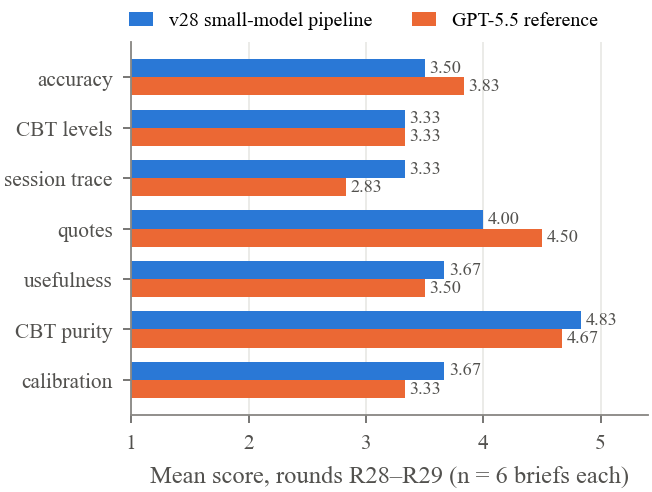
Viimastes voorudes said parim väikese mudeli versioon ja võrdlusmudel hinded 3.77 vs 3.87 (R28) ning 3.77 vs 3.57 (R29). Kuue sama vooru paari erinevused olid −0.4, +0.2, −0.1, −0.5, +0.9, +0.2: keskmine +0.05, SD 0.49. Kumbki süsteem ei saavutanud järelevaataja sihiks seatud keskmist hinnet 4.0. Kriteeriumite kaupa edestas v28 võrdlusmudelit seansijälje ja kalibreerituse poolest, jäi maha täpsuses (kooskõla kuldse võrdlusega) ja tsitaatides ning oli CBT tasemete osas võrdne.
Kulu
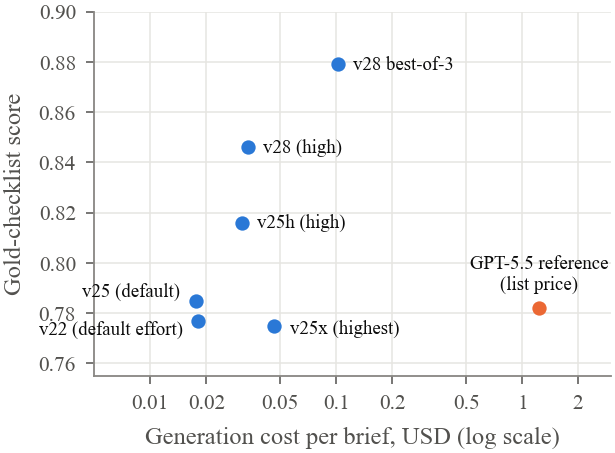
Üks v28 ülevaade maksab jaotiste kirjutamise eest umbes USD 0.03 ja selle koostamine võtab 2.5–3 minutit; parima kolmest ülevaade maksab umbes USD 0.11. Uue seansi töötlemine lisab umbes USD 0.07, millest suurem osa kulub iga lause klassifikaatoriga läbivaatamisele. Hinnakirja järgi maksab tipptaseme võrdlusülevaade umbes 19 korda rohkem kui üks v28 ülevaade. Kogu projekt kasutas väikese mudeli tokeneid väärtuses USD 5.57.
Mis aitas ja mis mitte
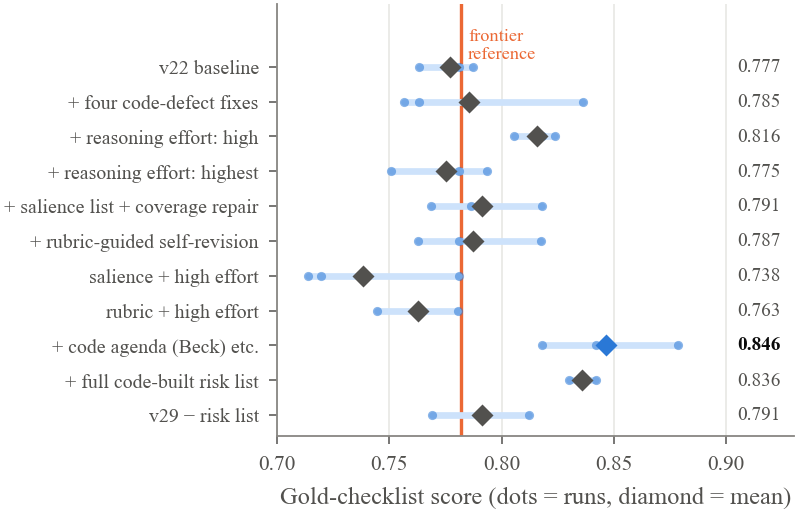
Kolm asja aitasid: deterministliku koodi vigade parandamine, mille leidis järelevaataja; jaotiste kirjutajate kõrge arutluspingutuse seade (kõrgeim seade maksis rohkem ja andis madalama skoori); ning soovitatud päevakorra, ennustuste riba ja viimase riskiga seotud väite viimine koodi. Mitmed usutavana tundunud lisandused mõjusid halvasti: kolme mustandi ühendamine, koodi abil kehtestatud uskumuste ajajoon, olulisuse vihjed koos katvuse parandamise etapiga ning hindamisrubriigiga suunatud eneserevisjon. Igaüks neist lisas genereerimisetapi, kus väike mudel võib teavet kaotada või moonutada. Kõik muudatused, mis vähendasid mudeli tööd või valisid väljundite vahel neid ümber kirjutamata, olid ohutud.
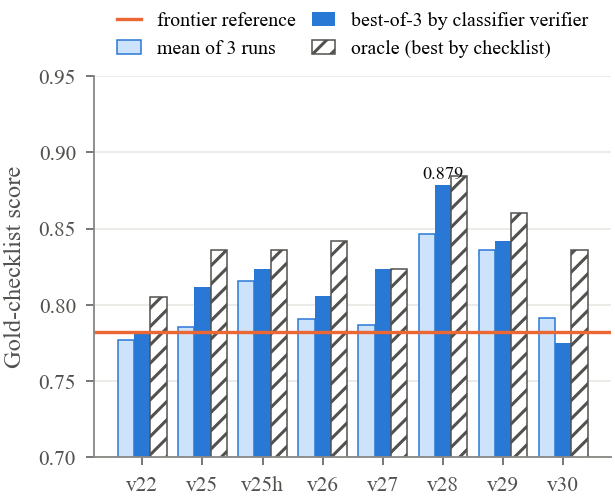
Verifikaatoriga valimine parandas kontrollnimekirja skoori kaheksast versioonist seitsmel; v28 puhul 0.846-lt 0.879-ni, mis on oraakeli tulemuse lähedal (0.885). Kuna verifikaator ja kontrollnimekirja hindaja on sama klassifikaator, võib osa sellest paranemisest peegeldada jagatud eelistusi.
Mis jäi keeruliseks
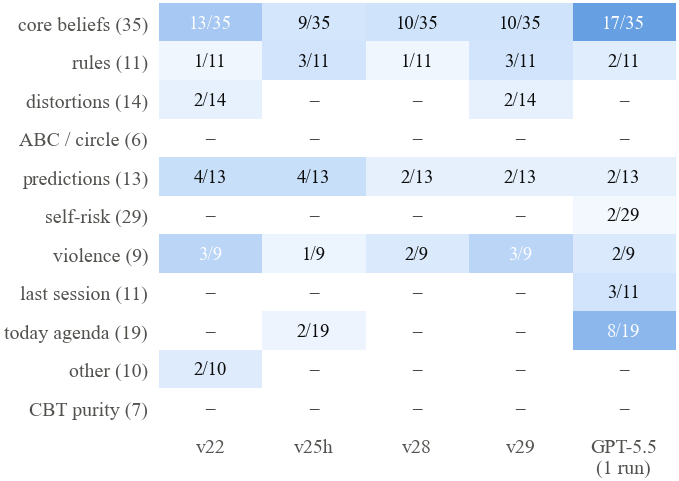
Püsivate vigade arv vähenes v22 ja v28 vahel 25-lt 15-le 164 kaalutud ühikust. Alles jäävad kognitiivse mudeli kõige peenemad hinnangud: uskumuse seisund pärast selle taasaktiveerimist, uskumuste vahemikud, mis peatuvad enne uusimat materjali, ning ulatuse täpsustused. Riskiga seotud väited olid kõige keerulisem osa: karistada sai nii hiljutise väite väljajätmise kui ka metafoori, harjutuse või emotsiooni hinnangu signaaliks tõlgendamise eest. Parim lahendus jättis alles ainult viimase sõnasõnalise väite ja seansi, kus terapeut selle kohta viimati otse küsis, ning jättis kõik tõlgendused terapeudile.
Hindaja on osa katsest
Kuna võrdlusülevaade ei muutunud, mõõdavad selle hinded üksnes järelevaatajat.
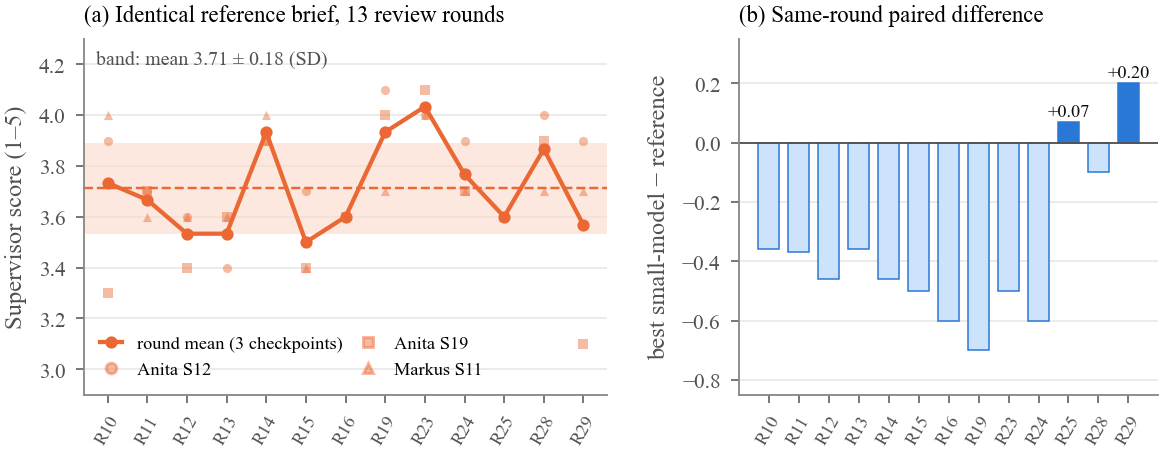
13 vooru jooksul sai identne võrdlusülevaade 1–5 skaalal vooru keskmiseks hindeks 3.71, SD-ks 0.18 ja vahemikuks 3.50–4.03. Üksikkriteeriumite SD ulatus 0.46-ni, sealhulgas skripti abil kontrollitud tsitaatide puhul, mis olid iga kord identsed. See varieeruvus on ligikaudu sama suur kui kogu paranemine, mille tsükkel samal skaalal saavutas.
Mida see uuring ei näita
- Ainult sünteetilised andmed. Kaks sünteetilist patsienti, kolm kontrollpunkti, kolm käivitust versiooni kohta. Ainult kirjeldav statistika, olulisuse teste ei tehtud. Ülekantavust teistele ülesannetele ja päris materjalile põhjendatakse, kuid ei näidata.
- Ainult mudelipõhine hindamine. Teadlikult ei osalenud kliinikuid ega teisi inimhindajaid. Skoorid kirjeldavad kooskõla kuldse kontrollnimekirja ja LLM-järelevaataja hinnanguga, mitte kliinilist kvaliteeti, ohutust ega mingit mõju teraapiale.
- Häälestatud hindamiskogumil. Kõik versioonid töötati välja samade kontrollpunktide ja hindajate alusel, mistõttu on lõplikud skoorid optimistlikud. Õige katse oleks kasutada eraldi hoitud patsienti.
- Eristamatus ei tähenda paremust. Pimedas ülevaatuses ei olnud väikest mudelit ja tipptaseme võrdlusmudelit selle valimi suuruse juures võimalik eristada; erinevused jäävad hindaja enda varieeruvuse piiresse.
- Sama klassifikaator. Kontrollnimekirja hindaja, lausete skanner ja verifikaator on sama mudel.
- Mõõdukas võrdlustase. Tipptaseme võrdlus on üks varasem optimeerimata töövoo käivitus, mis tehti ühe korra mudeliga GPT-5.5; see ei ole sama tsükliga häälestatud tipptaseme töövoog.
Loe artiklit ja kontrolli arvandmeid
Täismahus artikli saab tasuta alla laadida. Andmepakett koos kontrollnimekirjade, skooride ja näidisülevaadetega saadetakse e-postiga.
Artikkel
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Eeltrükk, 13 lk, 9 joonist.
Laadi andmepakett alla
Artikli PDF, kõik üheksa joonist, kolm kuldset kontrollnimekirja, kõigi versioonide kontrollnimekirja ja verifikaatori skoorid, viimaste voorude pimedad ülevaatused koos nende tähevastetega ning kolm viimast näidisülevaadet. README selgitab kõiki välju.
Me ei jaga e-posti aadresse. Andmelink saabub mõne minuti jooksul.
ZIP-faili sisu
paper/: artikkel PDF-failinafigures/: üheksa joonist ja nende aluseks olevad arvandmedscores/gold_checklists.json: 3 × 25 kaalutud väidetscores/checklist_results.json: üksikväidete tõenäosused 198 hinnatud ülevaate kohtascores/blind_review_R28.json,R29: seitse kriteeriumi, otsused ja vastuväited koos tähevastetegaexample-briefs/: kolm viimast v28 ülevaadet (poola keeles, nagu transkriptsioonid)
Ei sisalda: sünteetilisi transkriptsioone, viipasid ega koodi. Need on teadustöö tegemiseks saadaval autoritelt taotluse alusel.
Viitamine
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}