Mały model, staranny pipeline
Metoda autoresearch, która zmniejsza dystans do czołowych modeli LLM przy streszczaniu długiego materiału z wielu dokumentów. Sprawdzona na briefach przed sesją, budowanych z transkryptów dwojga syntetycznych pacjentów.
Tani model może się zbliżyć, jeśli robi mniej
Czołowe modele językowe dobrze streszczają długi materiał z wielu dokumentów, ale uruchamianie ich przed każdym wynikiem szybko robi się drogie. Małe modele są tanie, ale gubią informacje w długich wejściach. Sprawdziliśmy, jak daleko zajdzie tani model osadzony w starannie zaprojektowanym pipelinie i ulepszany przez zautomatyzowaną pętlę, w której każdą zmianę oceniają inne modele, bez oceniających ludzi.
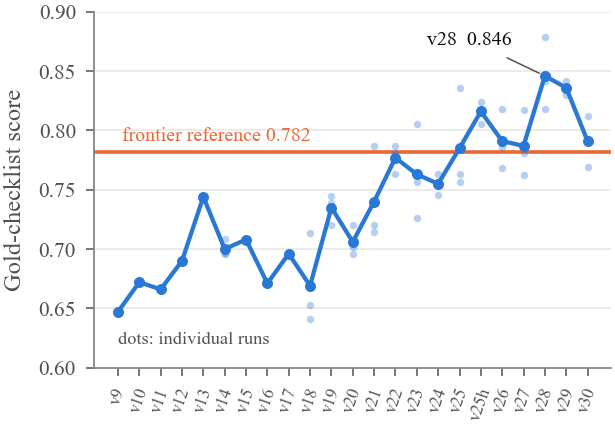
W 30 wersjach i 16 rundach ślepej recenzji mały model przeszedł od 0,647 do 0,846 na ważonej złotej checkliście (0,879, gdy z trzech przebiegów najlepszy wybiera weryfikator bez dostępu do wzorca). Wzorzec z modelu czołowego uzyskał 0,782. W ślepej recenzji superwizora-LLM przy tej liczebności próby nie dało się ich odróżnić: średnia różnica w parach wyniosła +0,05 (SD 0,49). Ten sam, niezmieniony brief wzorcowy dostawał od tego superwizora od 3,50 do 4,03 w 13 rundach, więc szum samego sędziego okazał się osobnym wynikiem.
Spis treści
Długie wejście, stała struktura, rutynowe użycie
Wiele praktycznych zadań streszczania ma trzy wspólne cechy: wejście jest długie i rozproszone po wielu dokumentach, wynik ma stałą strukturę z liczbami, datami i dosłownymi cytatami, a powstaje rutynowo, więc koszt ma znaczenie.
Jako poligon testowy wybraliśmy jedno takie zadanie: ustrukturyzowany brief, który terapeuta CBT może przeczytać w około trzy minuty przed sesją. Zawiera przekonania kluczowe z liczbą sesji, zasady, powracające zniekształcenia, typowe epizody ABC, sprawdzane predykcje, ostatnią sesję i punkty, które terapeuta może chcieć poruszyć dziś. Przed 20. sesją materiał liczy około 130 000 słów.
Zadanie dobrze nadaje się do pytania metodologicznego, bo ma znaną strukturę (model poznawczy Becka), naturalne pojęcie sprawdzalnego dowodu (dosłowne słowa pacjenta) i kilka pułapek: przekonanie, które pierwszy sformułował terapeuta, albo metaforę, która nie jest wypowiedzią o śmierci.
Dwoje syntetycznych pacjentów
Oboje pacjenci powstali naszą warstwową metodą tworzenia syntetycznych pacjentów (najpierw arkusz profilu, łuk terapeutyczny, plan sesji i przewodnik po sposobie mówienia, potem sesje generowane jedna po drugiej jako transkrypty w stylu ASR). Anita: 20 sesji, 131 498 słów, CBT w stylu J. Beck. Markus: 12 sesji, 83 978 słów, z terapeutą pracującym częściowo w terapii schematu, więc brief musi przełożyć materiał z powrotem na język CBT. Dla każdego pacjenta niezależnie, po pełnej lekturze transkryptów, napisano złoty wzorzec. Nie użyto danych żadnego realnego pacjenta.
Podział pracy
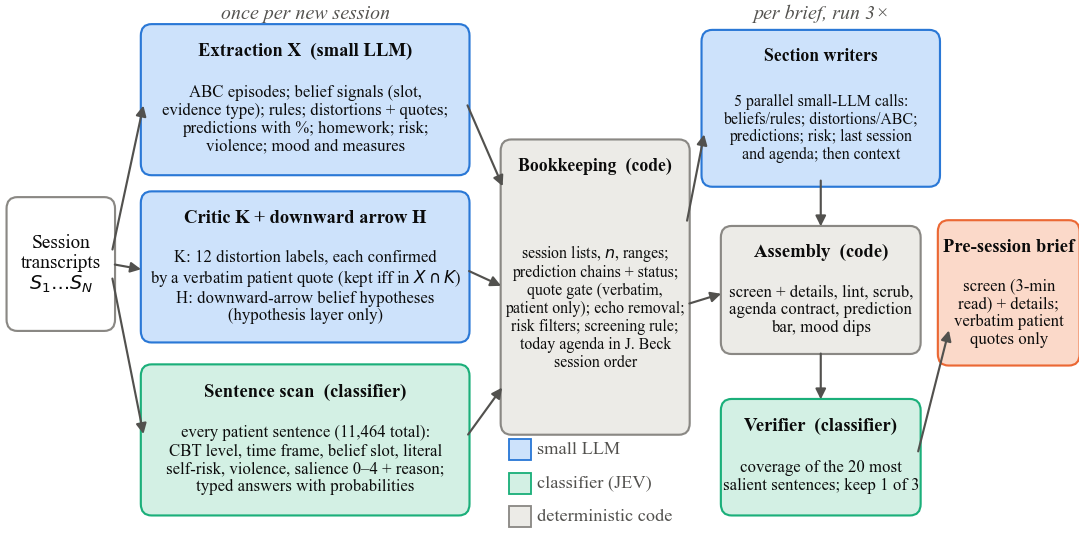
Przełom nie przyszedł z lepszych promptów, tylko z innego podziału odpowiedzialności. Każdy element robi tylko to, w czym jest dobry.
Kod deterministyczny
Wszystko, co da się policzyć, uporządkować albo sprawdzić
Listy sesji, liczby i zakresy dla każdego przekonania; łańcuchy predykcji powiązane między sesjami; bramka dosłownych cytatów, która odrzuca każdy cytat nieznaleziony w wypowiedziach pacjenta; usuwanie ech terapeuty; a od wersji 28 także kolejność proponowanych punktów na dzisiejszą sesję. Raz znaleziony błąd w tym kodzie zostaje naprawiony na stałe.
Klasyfikator zdań
Oceny, które nie wymagają generowania tekstu
Każde zdanie pacjenta (łącznie 11 464) dostaje raz etykiety: poziom CBT (myśl automatyczna, zasada, przekonanie, emocja, zachowanie…), ramę czasową (teraz czy wspomnienie), sformułowanie dosłowne czy przenośne oraz to, na ile zdanie może być istotne dla kolejnej sesji, każdą z prawdopodobieństwem. Ten sam klasyfikator służy potem jako weryfikator bez wzorca i jako oceniający checklistę.
Mały model językowy
Krótkie pisanie z przygotowanego materiału
Dla każdej sesji mały model wyciąga strukturę, potwierdza zniekształcenia dosłownymi cytatami i proponuje hipotezy (zapisywane jako hipotezy, nigdy jako dowód). Dla każdego briefu równolegle działa pięciu autorów sekcji; każdy widzi tylko dane swojej sekcji z numerami sesji i ma zakaz wymyślania numerów sesji i cytatów.
Najlepszy z trzech, bez zaglądania do odpowiedzi
Różnice między przebiegami tej samej wersji bywały większe niż różnice między wersjami. Dlatego część briefowa pipeline'u uruchamia się trzy razy, a weryfikator wybiera jeden wynik: bierze 20 najbardziej istotnych zdań pacjenta i pyta klasyfikator, czy każde z nich znalazło odzwierciedlenie w briefie. Weryfikator nigdy nie widzi złotego wzorca ani checklisty.
Pętla autoresearch
Zautomatyzowana pętla rozwoju w duchu najnowszych prac o automatyzacji eksperymentów: zaproponuj jedną zmianę, uruchom ją i zachowaj tylko wtedy, gdy zgadzają się dwie niezależne miary.
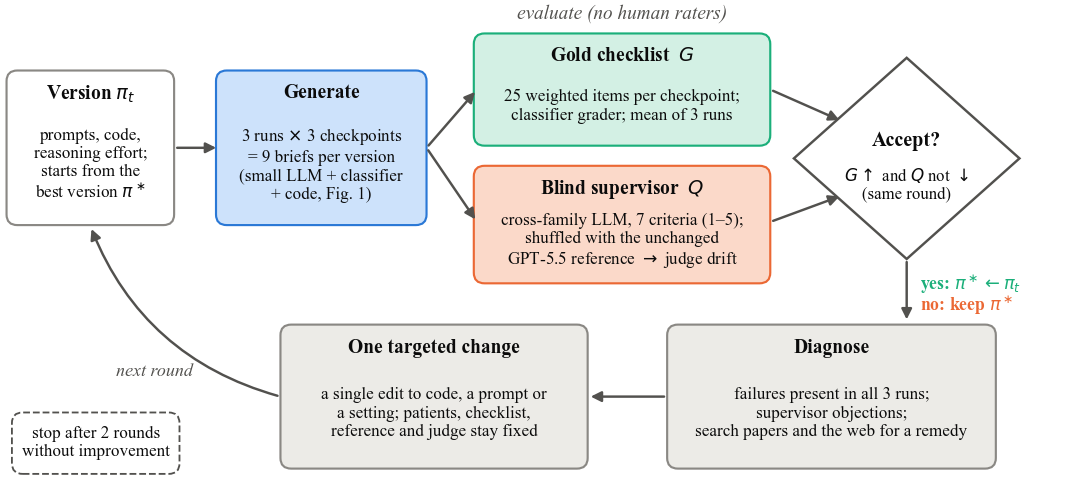
- Dwie miary. Złota checklista z 25 ważonymi stwierdzeniami na punkt kontrolny, oceniana przez klasyfikator, oraz ślepa recenzja superwizora-LLM z innej rodziny modeli, który ocenia siedem kryteriów w skali 1–5.
- Stała kotwica. Superwizor zawsze widzi też jeden niezmieniony brief wzorcowy pod losową literą, więc dryf samego sędziego jest mierzony w każdej rundzie.
- Jedna zmiana naraz. Błędy obecne we wszystkich trzech przebiegach i zarzuty superwizora wyznaczają jedną celowaną zmianę na rundę, popartą przeglądem literatury.
- Stała reguła stopu. Dwie kolejne rundy bez poprawy kończą pętlę. Zatrzymała się na v28.
- Stały limit kosztu. Wewnątrz pipeline'u nie wolno użyć modelu droższego niż mały model lub klasyfikator.
Co zaobserwowaliśmy
Statystyka opisowa na trzech punktach kontrolnych (Anita przed sesjami 13 i 20, Markus przed sesją 12) i trzech przebiegach na wersję.
Pokrycie treści: złota checklista
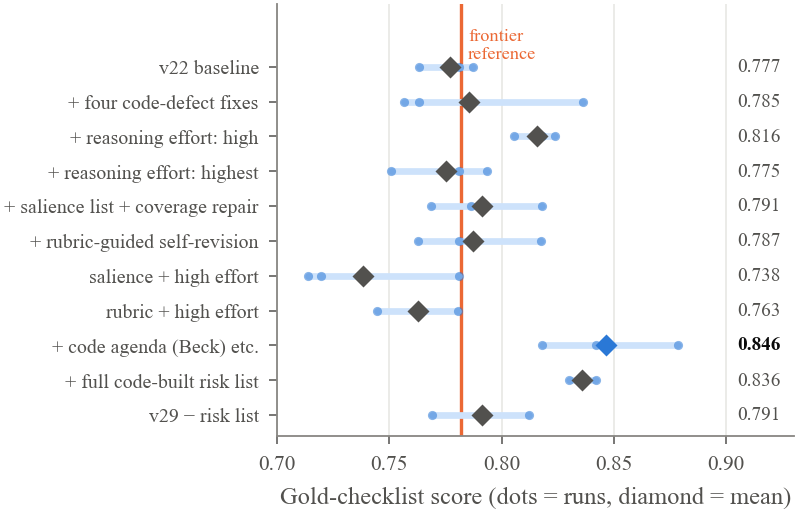
Mały model startował wyraźnie poniżej wzorca (0,647 wobec 0,782), przeciął go w v25 i doszedł do 0,846 w v28. Wszystkie trzy przebiegi v28 (0,818; 0,842; 0,879) leżą powyżej wzorca. Dwie późniejsze wersje nie poprawiły v28 i pętla się zatrzymała.
| Anita, przed S13 | Anita, przed S20 | Markus, przed S12 | |
|---|---|---|---|
| v28, średnia z 3 przebiegów | 0,963 | 0,800 | 0,776 |
| v28, best-of-3 (weryfikator) | 0,963 | 0,836 | 0,836 |
| Wzorzec GPT-5.5 (1 przebieg) | 0,963 | 0,655 | 0,727 |
Średnie z punktów kontrolnych: v28 0,846 · best-of-3 0,879 · wzorzec 0,782.
Ślepa recenzja: w granicach szumu sędziego
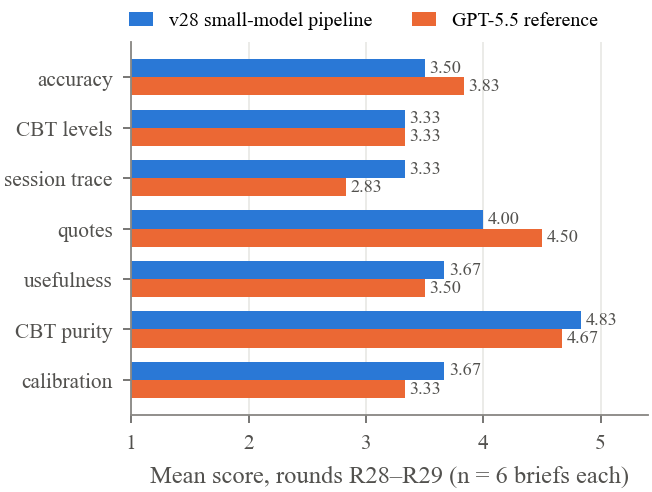
W ostatnich rundach najlepsza wersja małego modelu i wzorzec uzyskały 3,77 wobec 3,87 (R28) oraz 3,77 wobec 3,57 (R29). W sześciu parach z tych samych rund różnice wyniosły −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: średnio +0,05, SD 0,49. Żaden system nie osiągnął docelowej średniej superwizora 4,0. W rozbiciu na kryteria v28 prowadził w śladzie sesji i kalibracji, ustępował w trafności (zgodności ze złotym wzorcem) i cytatach, a w poziomach CBT był na równi.
Koszt
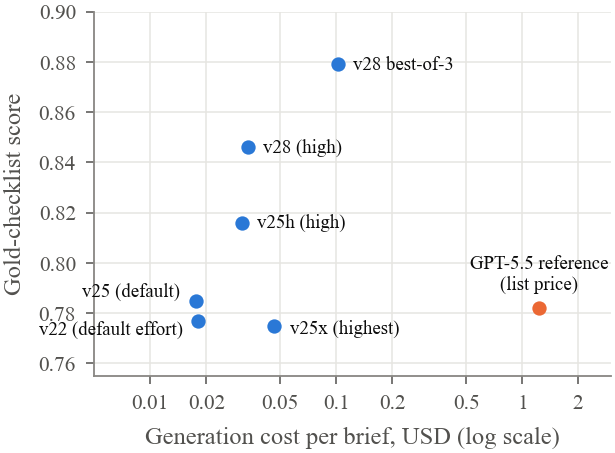
Jeden brief v28 kosztuje około 0,03 USD za pisanie sekcji i powstaje w 2,5–3 minuty; brief best-of-3 około 0,11 USD. Przetworzenie nowej sesji dokłada około 0,07 USD, głównie za przejście klasyfikatora przez każde zdanie. W cenach katalogowych brief wzorcowy kosztuje około 19 razy więcej niż pojedynczy brief v28. Cały projekt zużył tokeny małego modelu za 5,57 USD.
Co pomogło, a co nie
Pomogły trzy rzeczy: naprawa błędów w kodzie deterministycznym, które znalazł superwizor; wysoki poziom rozumowania dla autorów sekcji (poziom najwyższy kosztował więcej i dawał niższe wyniki); oraz przeniesienie do kodu proponowanego planu na dziś, paska predykcji i najnowszej wypowiedzi związanej z ryzykiem. Kilka rozsądnie wyglądających dodatków zaszkodziło: łączenie trzech szkiców, narzucona kodem oś czasu przekonań, podpowiedzi istotności z przebiegiem naprawy pokrycia oraz autokorekta według rubryki. Każdy z nich dokładał krok generowania, w którym mały model może zgubić albo zniekształcić informację. Każda zmiana, która zabierała modelowi pracę albo wybierała spośród wyników bez ich przepisywania, była bezpieczna.
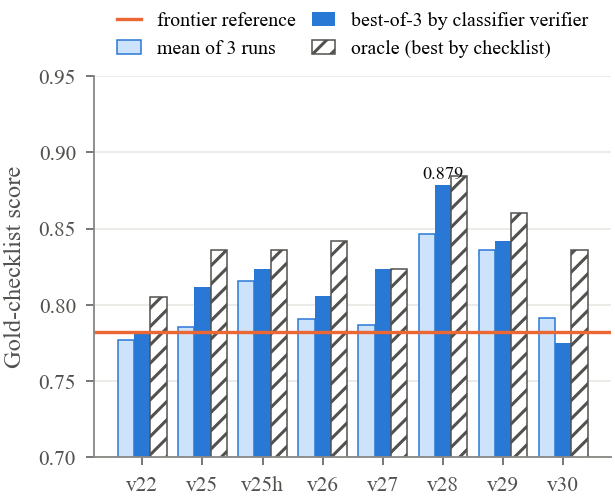
Wybór przez weryfikator poprawił wynik checklisty w siedmiu z ośmiu wersji; dla v28 z 0,846 do 0,879, blisko wyroczni (0,885). Ponieważ weryfikator i oceniający checklistę to ten sam klasyfikator, część tego zysku może wynikać ze wspólnych preferencji.
Co pozostało trudne
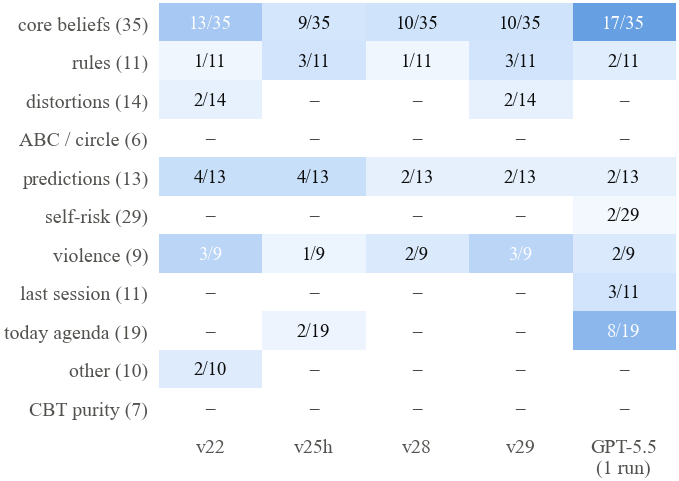
Trwałe błędy spadły z 25 do 15 ze 164 jednostek wagi między v22 a v28. Zostały najsubtelniejsze oceny modelu poznawczego: stan przekonania po jego reaktywacji, zakresy przekonań kończące się przed najnowszym materiałem i zastrzeżenia co do zakresu. Najtrudniejsze były linie dotyczące ryzyka: karane było zarówno pominięcie niedawnej wypowiedzi, jak i zrobienie sygnału z metafory, ćwiczenia czy oceny emocji. Najlepszy układ zostawiał tylko najnowszą dosłowną wypowiedź i sesję, w której terapeuta ostatnio pytał o to wprost, a każdą interpretację zostawiał terapeucie.
Sędzia jest częścią eksperymentu
Brief wzorcowy nigdy się nie zmieniał, więc jego oceny mierzą wyłącznie superwizora.
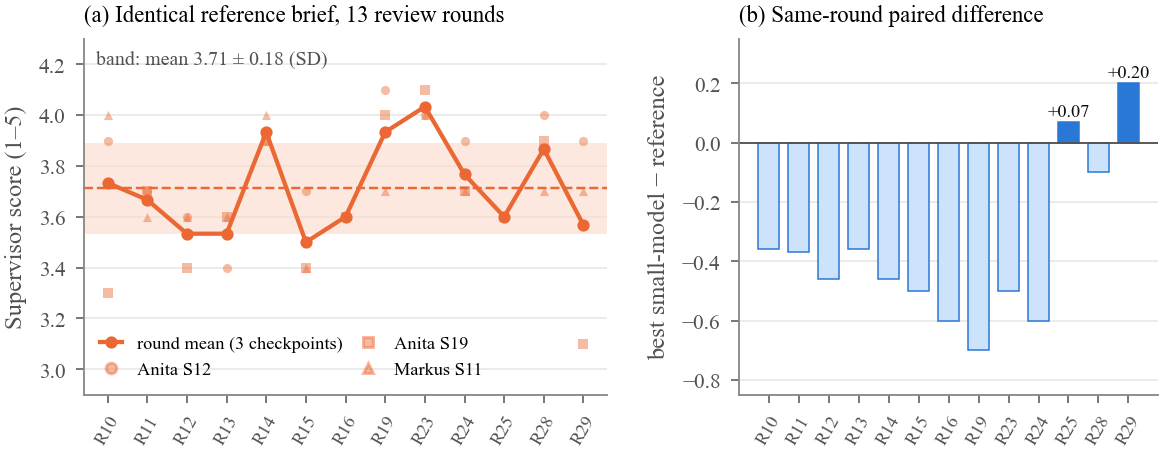
W 13 rundach identyczny brief wzorcowy uzyskał średnią 3,71 przy SD 0,18 i rozpiętości 3,50–4,03 w skali 1–5. Na pojedynczych kryteriach SD sięgało 0,46, także dla cytatów, które za każdym razem były identyczne i sprawdzone skryptem. Ten szum jest mniej więcej tak duży jak cała poprawa, którą pętla osiągnęła na tej samej skali.
Czego to badanie nie pokazuje
- Tylko dane syntetyczne. Dwoje syntetycznych pacjentów, trzy punkty kontrolne, trzy przebiegi na wersję. Wyłącznie statystyka opisowa, bez testów istotności. Przeniesienie na inne zadania i na realny materiał jest uzasadnione argumentami, nie wykazane.
- Tylko ocena modelowa. Z założenia nie brali udziału klinicyści ani inni oceniający ludzie. Wyniki opisują zgodność z checklistą wzorcową i ocenę superwizora-LLM, a nie jakość kliniczną, bezpieczeństwo ani wpływ na terapię.
- Dostrajanie na zbiorze ewaluacyjnym. Wszystkie wersje rozwijano na tych samych punktach kontrolnych i sędziach, więc wyniki końcowe są optymistyczne. Właściwym testem byłby pacjent odłożony z boku.
- Nieodróżnialny to nie lepszy. W ślepej recenzji małego modelu i wzorca nie dało się odróżnić przy tej liczebności próby; różnice mieszczą się w szumie samego sędziego.
- Wspólny klasyfikator. Oceniający checklistę, skaner zdań i weryfikator to ten sam model.
- Skromny wzorzec. Wzorzec to jeden wcześniejszy, niezoptymalizowany pipeline uruchomiony raz z GPT-5.5, a nie pipeline czołowy dostrojony tą samą pętlą.
Przeczytaj artykuł, sprawdź liczby
Pełny artykuł (po angielsku) można pobrać bezpłatnie. Paczkę danych z checklistami, wynikami i przykładowymi briefami wysyłamy mailem.
Artykuł
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Preprint, 13 stron, 9 wykresów, po angielsku.
Pobierz paczkę danych
PDF artykułu, wszystkie dziewięć wykresów, trzy złote checklisty, wyniki checklisty i weryfikatora dla każdej wersji, ślepe recenzje z ostatnich rund z kluczami liter oraz trzy finalne przykładowe briefy. README objaśnia każde pole.
Nie udostępniamy adresów. Link do danych przychodzi w ciągu kilku minut.
Co jest w ZIP-ie
paper/: artykuł w PDFfigures/: dziewięć wykresów i liczby, z których powstałyscores/gold_checklists.json: 3 × 25 ważonych stwierdzeńscores/checklist_results.json: prawdopodobieństwa dla każdego punktu w 198 ocenionych briefachscores/blind_review_R28.json,R29: siedem kryteriów, werdykty i zarzuty, z kluczami literexample-briefs/: trzy finalne briefy v28 (po polsku, jak transkrypty)
Nie zawiera: syntetycznych transkryptów, promptów i kodu. Udostępniamy je na prośbę, do celów badawczych.
Jak cytować
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}