Малък модел, внимателно изградена pipeline система
Метод за autoresearch за намаляване на разликата спрямо frontier LLM при обобщаване на дълги документи от множество източници. Тестван върху резюмета преди сесия, изготвени въз основа на транскрипти на двама синтетични пациенти.
Евтин модел може да се доближи, ако върши по-малко
Frontier езиковите модели обобщават добре дълги материали от множество източници, но използването на такъв модел преди всяка заявка е скъпо. Малките модели са евтини, но губят информация при дълги входни данни. Проверихме докъде може да стигне нискобюджетен модел, когато е включен във внимателно проектирана pipeline система и се усъвършенства чрез автоматизиран цикъл, който оценява всяка промяна с други модели, без човешки оценители.
В рамките на над 30 версии и 16 кръга сляпа оценка резултатът на малкия модел по претеглен златен контролен списък се повиши от 0,647 до 0,846 (0,879, когато verifier без достъп до референтния отговор избира най-добрия от три опита). Референтният frontier модел получи 0,782. При сляпа оценка от LLM надзорник двата модела не можаха да бъдат различени при този размер на извадката: средната разлика в сдвоените оценки беше +0,05 (SD 0,49). Същото, непроменено референтно резюме получаваше от надзорника оценки между 3,50 и 4,03 в рамките на 13 кръга, така че собствената шумност на оценяващия се оказа самостоятелно важно наблюдение.
Съдържание
Дълъг вход, фиксирана структура, рутинна употреба
Много практически задачи за обобщаване имат три общи характеристики: входът е дълъг и разпределен в множество документи, изходът следва фиксирана структура с броеве, дати и дословни откъси, а изходът се генерира рутинно, затова разходът е важен.
Като тестова задача използвахме един такъв пример: структурирано резюме, което КПТ-терапевт може да прочете за около три минути преди сесия. В него са изброени основните убеждения и броят на сесиите, правилата, повтарящите се когнитивни изкривявания, типичните епизоди ABC, проверените предсказания, последната сесия и темите, които терапевтът може да пожелае да обсъди в днешната сесия. Към 20-ата сесия материалът наброява около 130 000 думи.
Тази задача е подходяща за методологично изследване, защото има известна структура (когнитивния модел на Beck), естествен критерий за проверими доказателства (дословните думи на пациента) и няколко подводни камъка: убеждение, формулирано първоначално от терапевта, или метафора, която не представлява твърдение за смъртта.
Двама синтетични пациенти
И двамата пациенти бяха генерирани с нашия многоетапен метод за създаване на синтетични пациенти (първо профил, терапевтична траектория, план на сесиите и ръководство за речевия стил, след това сесиите се генерират една по една като транскрипти в стил ASR). Anita: 20 сесии, 131 498 думи, КПТ в стила на J. Beck. Markus: 12 сесии, 83 978 думи, с терапевт, който отчасти използва схемна терапия, затова резюмето трябва да преобразува материала обратно в термините на КПТ. За всеки пациент златният референтен материал беше изготвен самостоятелно след пълен прочит на транскриптите. Не са използвани данни от реални пациенти.
Разпределение на задачите
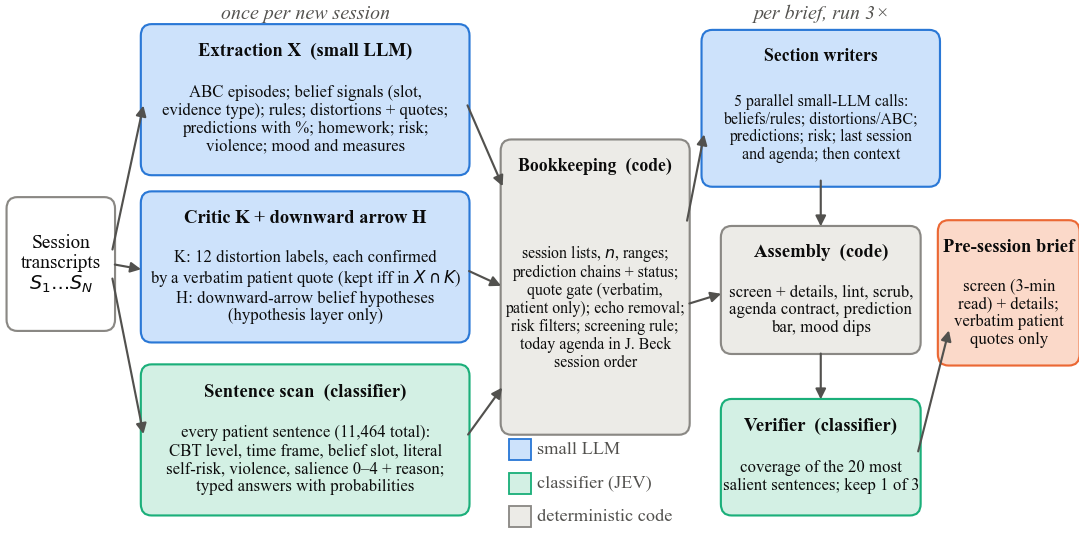
Решаващите промени не бяха в подобряването на подканите, а в преразпределянето на отговорностите. Всеки компонент върши само това, което му се удава добре.
Детерминистичен код
Всичко, което може да се преброи, подреди или провери
Списъци със сесии, броеве и диапазони за всяко убеждение; вериги от предсказания, свързани между сесиите; филтър за дословни цитати, който отхвърля всеки цитат, ако той не се среща в думите на самия пациент; премахване на повторенията от терапевта; а от версия 28 — и редът на предложените теми за днешната сесия. След като бъде открит дефект в този код, той се отстранява окончателно.
Класификатор на изречения
Преценки, за които не е нужно генериране на текст
Всяко изречение на пациента (общо 11 464) се маркира еднократно: ниво в КПТ (автоматична мисъл, правило, убеждение, емоция, поведение…), времева рамка (настояще или минало), буквална или образна формулировка и вероятна значимост на изречението за следващата сесия — всяка характеристика с оценка на вероятността. Същият класификатор по-късно се използва като verifier без достъп до референтния отговор и като оценител на контролния списък.
Малък езиков модел
Кратък текст въз основа на подготвен материал
За всяка сесия малкият модел извлича структура, потвърждава когнитивните изкривявания с дословни цитати и предлага хипотези (които се съхраняват като хипотези, а не като доказателства). За всяко резюме пет авторски модула работят паралелно; всеки от тях вижда само данните с номера на сесиите за собствената си секция и получава указание никога да не измисля номера на сесии или цитати.
Избор на най-добрия от три, без да се вижда отговорът
Разликите между изпълненията в рамките на една версия често бяха по-големи от разликите между версиите. Затова pipeline системата на ниво резюме се изпълнява три пъти и verifier избира един вариант: той взема 20-те най-значими изречения на пациента и моли класификатора да провери дали всяко от тях е отразено в резюмето. Verifier не вижда златния референтен материал или контролния списък.
Цикълът autoresearch
Автоматизиран цикъл на разработка в духа на неотдавнашните изследвания в областта на автоматизираните експерименти: предлага се една промяна, тя се изпробва и се запазва само ако две независими метрики сочат в една посока.
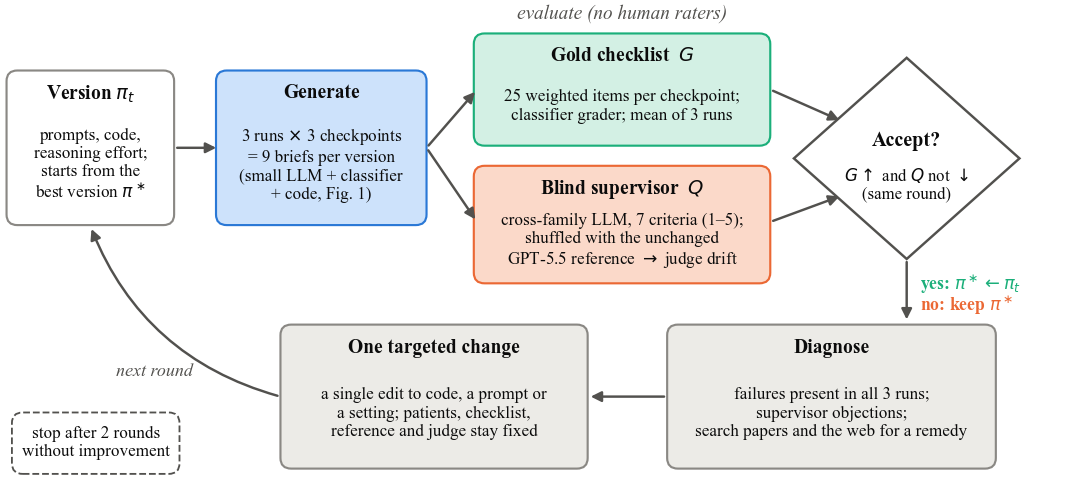
- Две метрики. Златен контролен списък от 25 претеглени твърдения за всяка контролна точка, оценяван от класификатора, и сляпа оценка от LLM надзорник от различно семейство модели, който оценява седем критерия по скала от 1 до 5.
- Фиксиран ориентир. Надзорникът винаги вижда и едно непроменено референтно резюме от frontier модел, обозначено със случайна буква, така че във всеки кръг се измерва собственото отклонение на оценяващия.
- Една промяна наведнъж. Случаи на неуспех, наблюдавани и в трите изпълнения, както и забележките на надзорника, насочват по една целева промяна на кръг въз основа на литературен обзор.
- Фиксирано правило за спиране. Два последователни кръга без подобрение прекратяват цикъла. Той спря при v28.
- Фиксиран таван на разходите. В pipeline системата не може да се използва модел, по-скъп от малкия модел или класификатора.
Какво наблюдавахме
Описателна статистика за три контролни точки (Anita преди сесии 13 и 20, Markus преди сесия 12) и по три изпълнения за всяка версия.
Пълнота на съдържанието: златният контролен списък
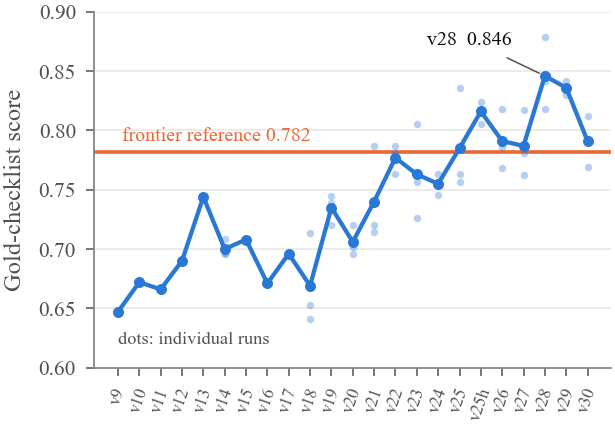
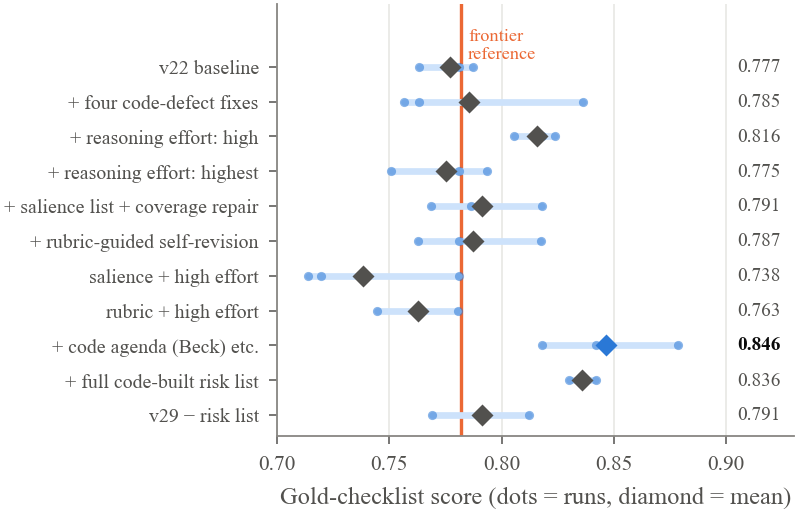
Първоначално резултатът на малкия модел значително отстававше от референтния (0,647 спрямо 0,782), надмина го при v25 и достигна 0,846 при v28. И трите изпълнения на v28 (0,818, 0,842, 0,879) надминават референтния резултат. Две последващи версии не показаха подобрение спрямо v28 и цикълът беше спрян.
| Anita, преди S13 | Anita, преди S20 | Markus, преди S12 | |
|---|---|---|---|
| v28, средно от 3 изпълнения | 0,963 | 0,800 | 0,776 |
| v28, най-добър от 3 (verifier) | 0,963 | 0,836 | 0,836 |
| Референтен GPT-5.5 (1 изпълнение) | 0,963 | 0,655 | 0,727 |
Средни стойности за контролните точки: v28 0,846 · best-of-3 0,879 · референтен модел 0,782.
Сляпа оценка: в рамките на шумността на оценяващия
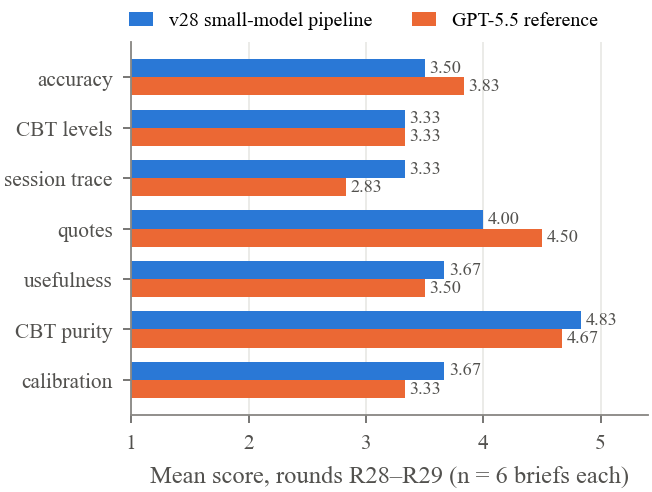
Във финалните кръгове най-добрата версия на малкия модел и референтният модел получиха оценки 3,77 спрямо 3,87 (R28) и 3,77 спрямо 3,57 (R29). В шест сдвоени сравнения от един и същи кръг разликите бяха −0,4, +0,2, −0,1, −0,5, +0,9, +0,2: средна стойност +0,05, SD 0,49. Нито една от системите не достигна целевата средна оценка на надзорника от 4,0. По критерии v28 имаше предимство при проследяване на сесиите и калибриране, изоставаше по точност (съответствие със златния референтен материал) и цитати и беше наравно по нивата в КПТ.
Разходи
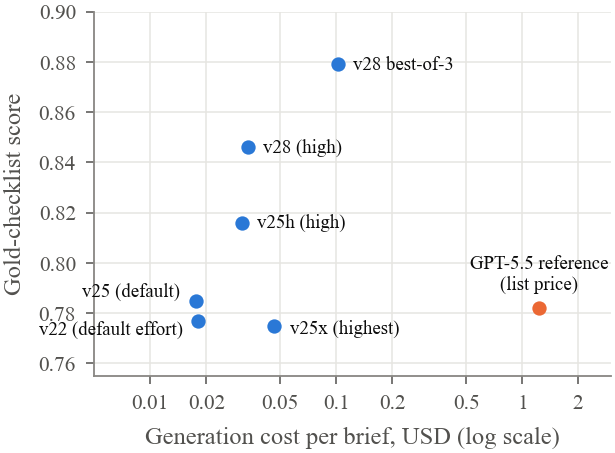
Едно резюме v28 струва около USD 0,03 за написването на секциите и отнема 2,5–3 минути; резюме best-of-3 струва около USD 0,11. Обработката на нова сесия струва още около USD 0,07, като основната част е класификаторът, който обработва всяко изречение. При каталожните цени едно резюме от frontier референтния модел струва около 19 пъти повече от едно резюме v28. Целият проект използва токени на малкия модел на стойност USD 5,57.
Какво помогна и какво не
Помогнаха три неща: отстраняването на дефекти в детерминистичния код, открити от надзорника; настройка high за усилието за разсъждение на авторските модули за секциите (настройката highest струваше повече и резултатът беше по-нисък); и преместването на предложените теми, лентата с предсказания и най-скорошното твърдение, свързано с риск, в кода. Няколко правдоподобни допълнения влошиха резултатите: обединяване на три чернови, времева линия на убежденията, зададена от кода, подсказки за значимост с последващо поправяне на пропуснато съдържание и самооценка с насоки от рубрика. Всяко от тях добавяше стъпка на генериране, при която малкият модел може да загуби или изопачи информация. Всички промени, които намаляваха работата на модела или избираха между резултати, без да ги пренаписват, бяха безопасни.
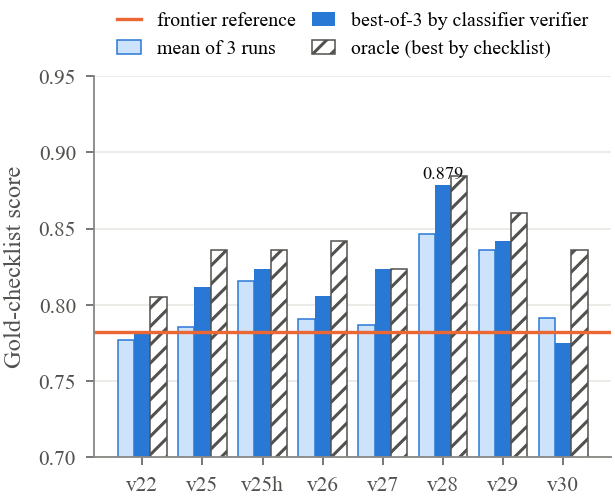
Изборът от verifier подобри резултата по контролния списък при седем от осем версии; при v28 — от 0,846 до 0,879, близо до оракула (0,885). Тъй като verifier и оценителят на контролния списък са един и същ класификатор, част от това подобрение може да отразява споделени предпочитания.
Какво остана трудно
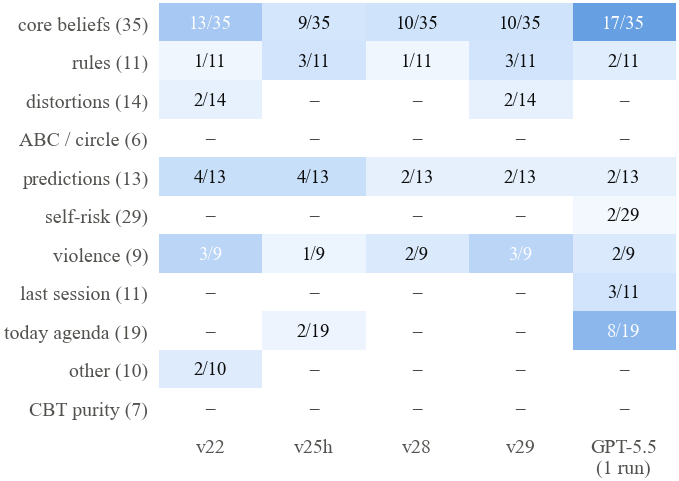
Броят на устойчивите неуспехи спадна от 25 на 15 от общо 164 единици тежест между v22 и v28. Останалите се отнасят до най-фините преценки на когнитивния модел: състоянието на дадено убеждение след повторното му активиране, диапазони на убежденията, които приключват преди най-новия материал, и уточнения за обхвата. Най-трудният компонент бяха твърденията за риск: санкционираха се както пропускането на скорошно твърдение, така и представянето на метафора, упражнение или оценка на емоция като сигнал. Най-добрият подход запазваше само най-скорошното буквално твърдение и сесията, в която терапевтът за последен път го беше попитал директно, а интерпретациите оставяше изцяло на терапевта.
Оценяващият е част от експеримента
Тъй като референтното резюме никога не се променяше, неговите оценки измерват единствено работата на надзорника.
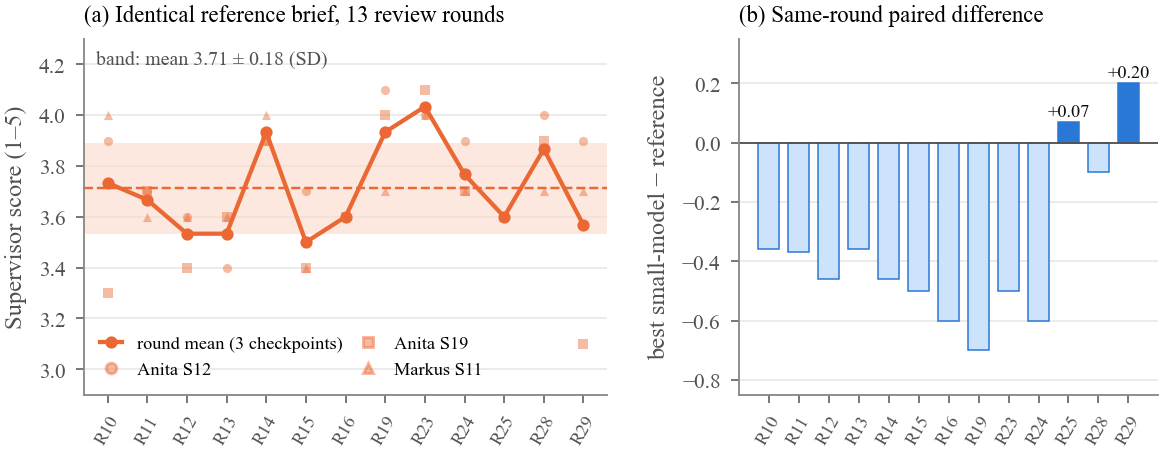
В рамките на 13 кръга непромененото референтно резюме получи средна оценка за кръг 3,71 със SD 0,18 и диапазон 3,50–4,03 по скала от 1 до 5. При отделните критерии SD достигаше 0,46, включително за цитати, които бяха проверени със скрипт и всеки път бяха идентични. Тази шумност е приблизително равна на цялото подобрение, постигнато от цикъла по същата скала.
Какво не показва това изследване
- Само синтетични данни. Двама синтетични пациенти, три контролни точки, три изпълнения за всяка версия. Само описателна статистика, без тестове за статистическа значимост. Преносимостта към други задачи и реални материали е аргументирана, но не е показана.
- Само оценяване от модели. По замисъл не са участвали клиницисти или други човешки оценители. Оценките описват съответствието със златен контролен списък и преценката на LLM надзорник, а не клиничното качество, безопасността или какъвто и да е ефект върху терапията.
- Настройване върху набора за оценяване. Всички версии са разработвани спрямо едни и същи контролни точки и оценяващи, така че финалните оценки са оптимистични. Подходящият тест би бил с пациент, който не е използван при разработката.
- Неразличимостта не означава превъзходство. При сляпа оценка малкият модел и frontier референтният модел не можаха да бъдат различени при този размер на извадката; разликите са в рамките на собствената шумност на оценяващия.
- Общ класификатор. Оценителят на контролния списък, скенерът на изречения и verifier са един и същ модел.
- Умерен по сила референтен модел. Frontier референтният модел представлява едно по-ранно, неоптимизирано изпълнение на pipeline системата с GPT-5.5, а не frontier pipeline система, настроена със същия цикъл.
Прочетете статията, проверете числата
Пълният текст на статията е достъпен за безплатно изтегляне. Пакетът с данни, съдържащ контролни списъци, оценки и примерни резюмета, се изпраща по имейл.
Статията
Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation. Bartłomiej Głowacki, Joanna Głowacka, Bohdan Głowacki, Ewa Cylwik. AITHENTICA P.S.A. / Therapy Support, 2026. Предпубликация, 13 страници, 9 фигури.
Изтеглете пакета с данни
PDF на статията, всичките девет фигури, трите златни контролни списъка, оценки по контролния списък и verifier за всяка версия, слепи оценки от финалните кръгове с буквени ключове и три финални примерни резюмета. README описва всяко поле.
Не споделяме имейл адреси. Връзката към данните пристига в рамките на няколко минути.
Съдържание на ZIP файла
paper/: статията във формат PDFfigures/: девет фигури и данните, въз основа на които са изготвениscores/gold_checklists.json: 3 × 25 претеглени твърденияscores/checklist_results.json: вероятности за отделните елементи за 198 оценени резюметаscores/blind_review_R28.json,R29: седем критерия, заключения и забележки с буквени ключовеexample-briefs/: три финални резюмета v28 (на полски, както и транскриптите)
Не са включени: синтетични транскрипти, подкани и код. Те могат да бъдат предоставени от авторите при поискване за изследователски цели.
Как да цитирате
@misc{glowacki2026smallmodel,
  title  = {Small Model, Careful Pipeline: An Autoresearch Method for Closing the Gap to Frontier LLMs on Long, Multi-Document Summarisation},
  author = {G{\l}owacki, Bart{\l}omiej and G{\l}owacka, Joanna and G{\l}owacki, Bohdan and Cylwik, Ewa},
  year   = {2026},
  note   = {Preprint, AITHENTICA P.S.A. / Therapy Support},
  url    = {https://aitherapy.support/research/small-model-careful-pipeline/}
}